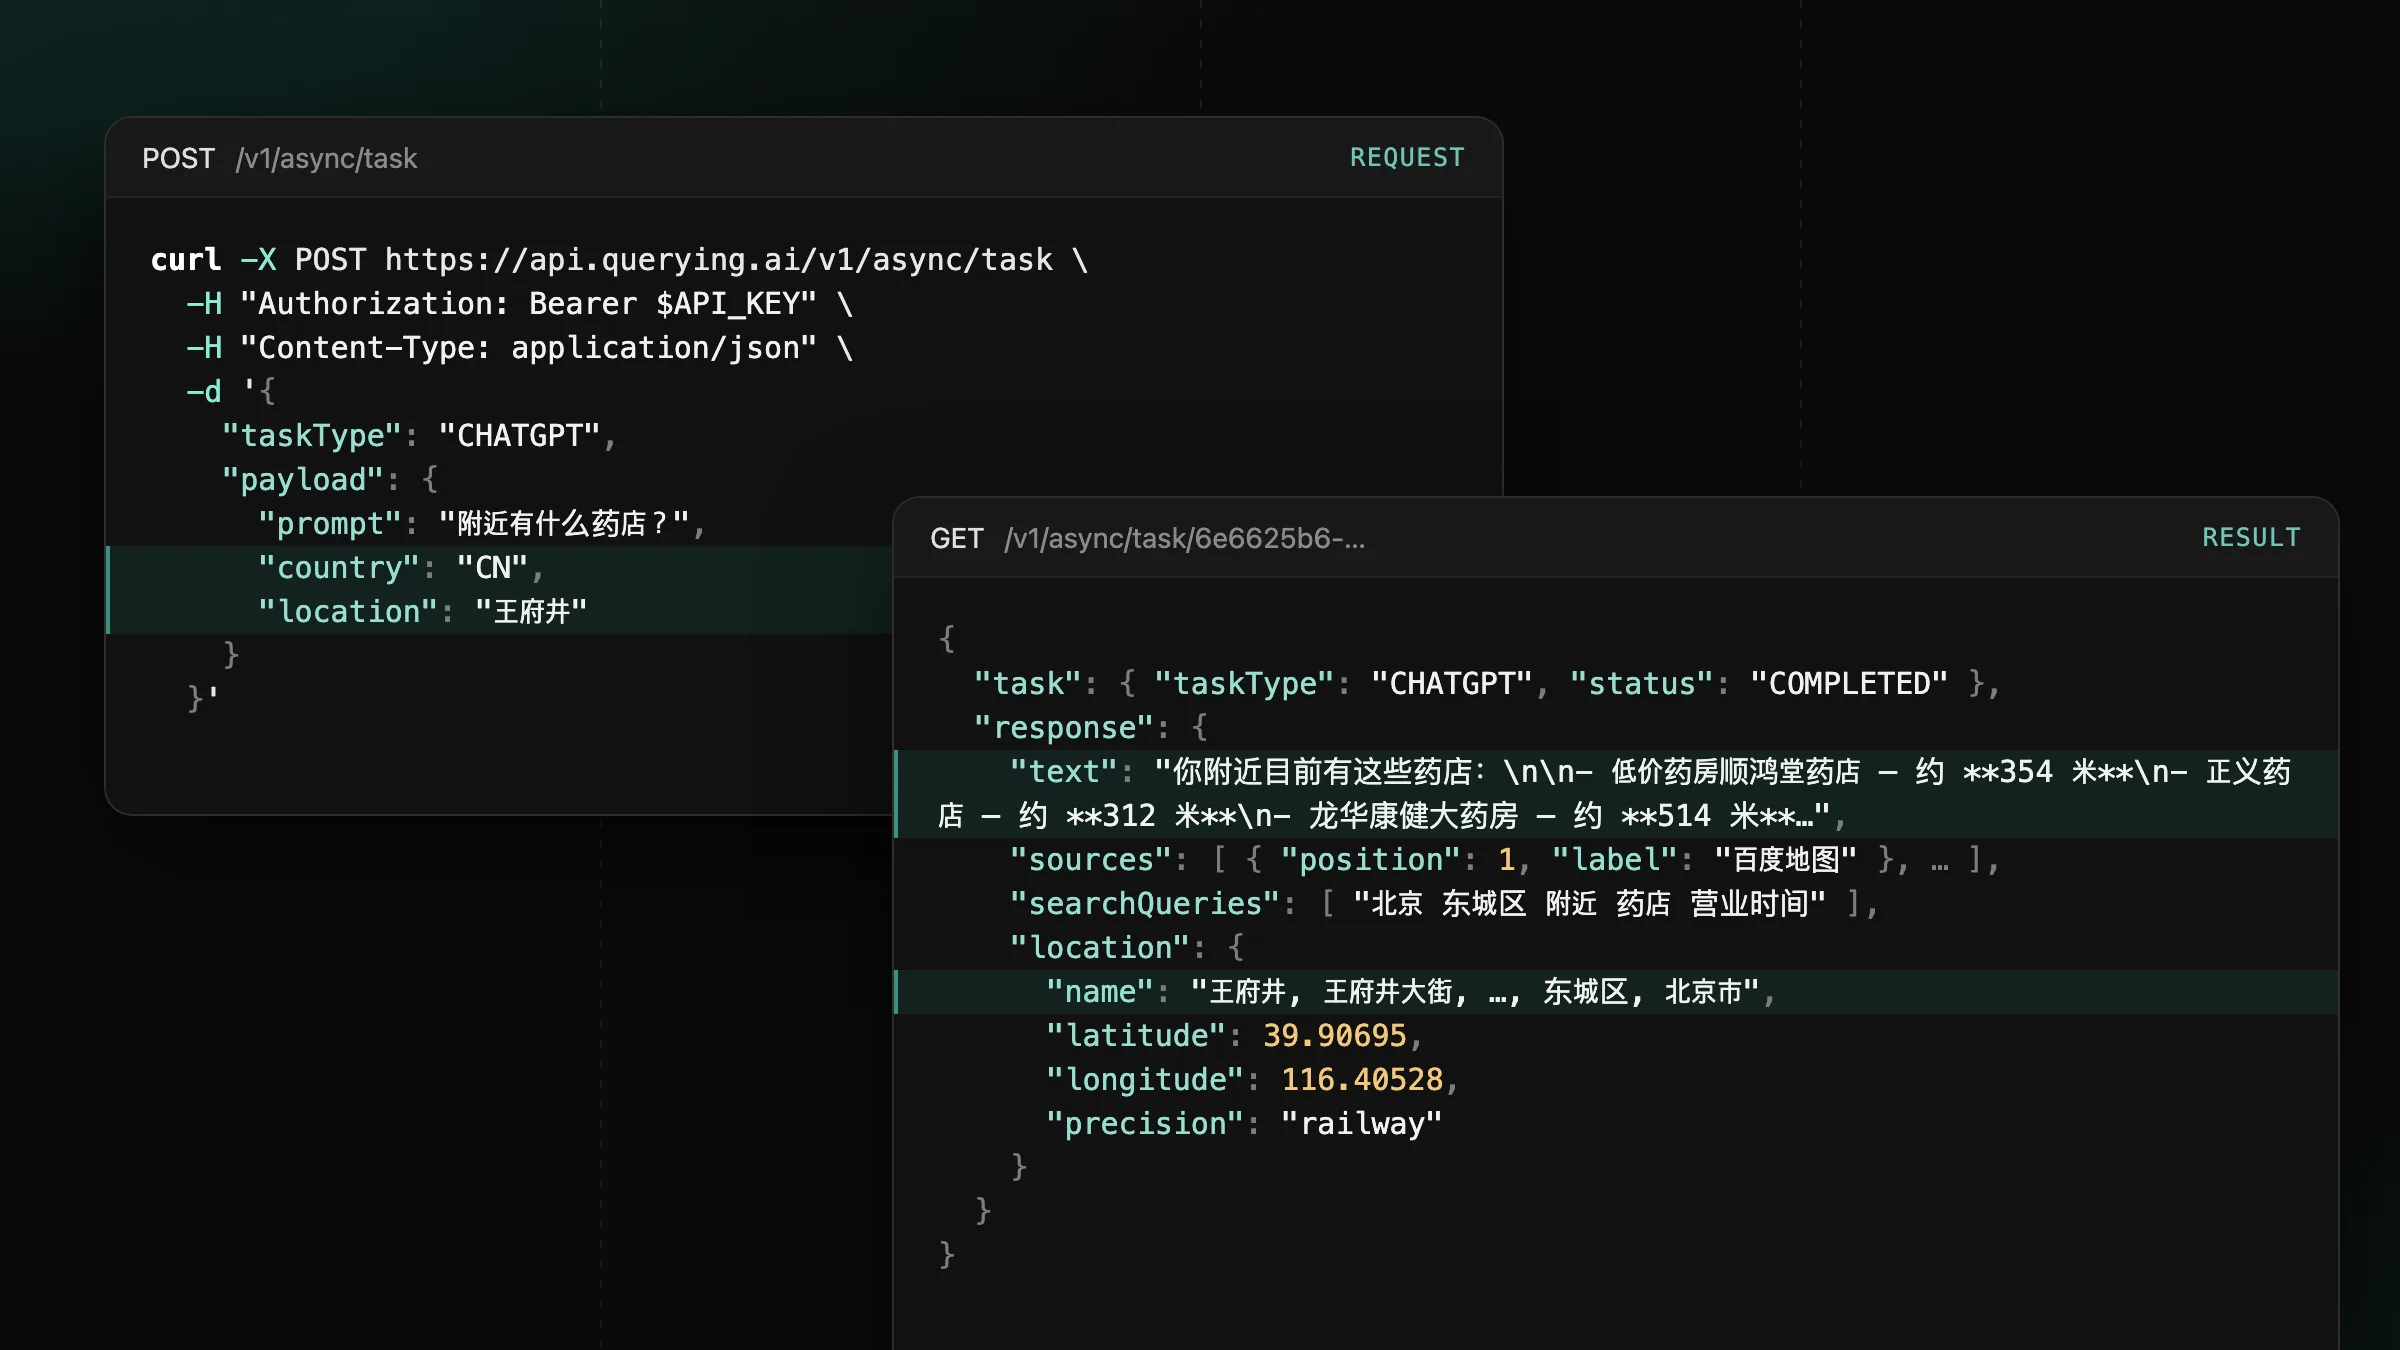
ChatGPT、Gemini 和 Google 现已支持中国大陆
在 CHATGPT、GEMINI 和 GOOGLE 任务中将 country 设为 CN 或 HK,即可获得中国大陆和香港用户看到的回答。
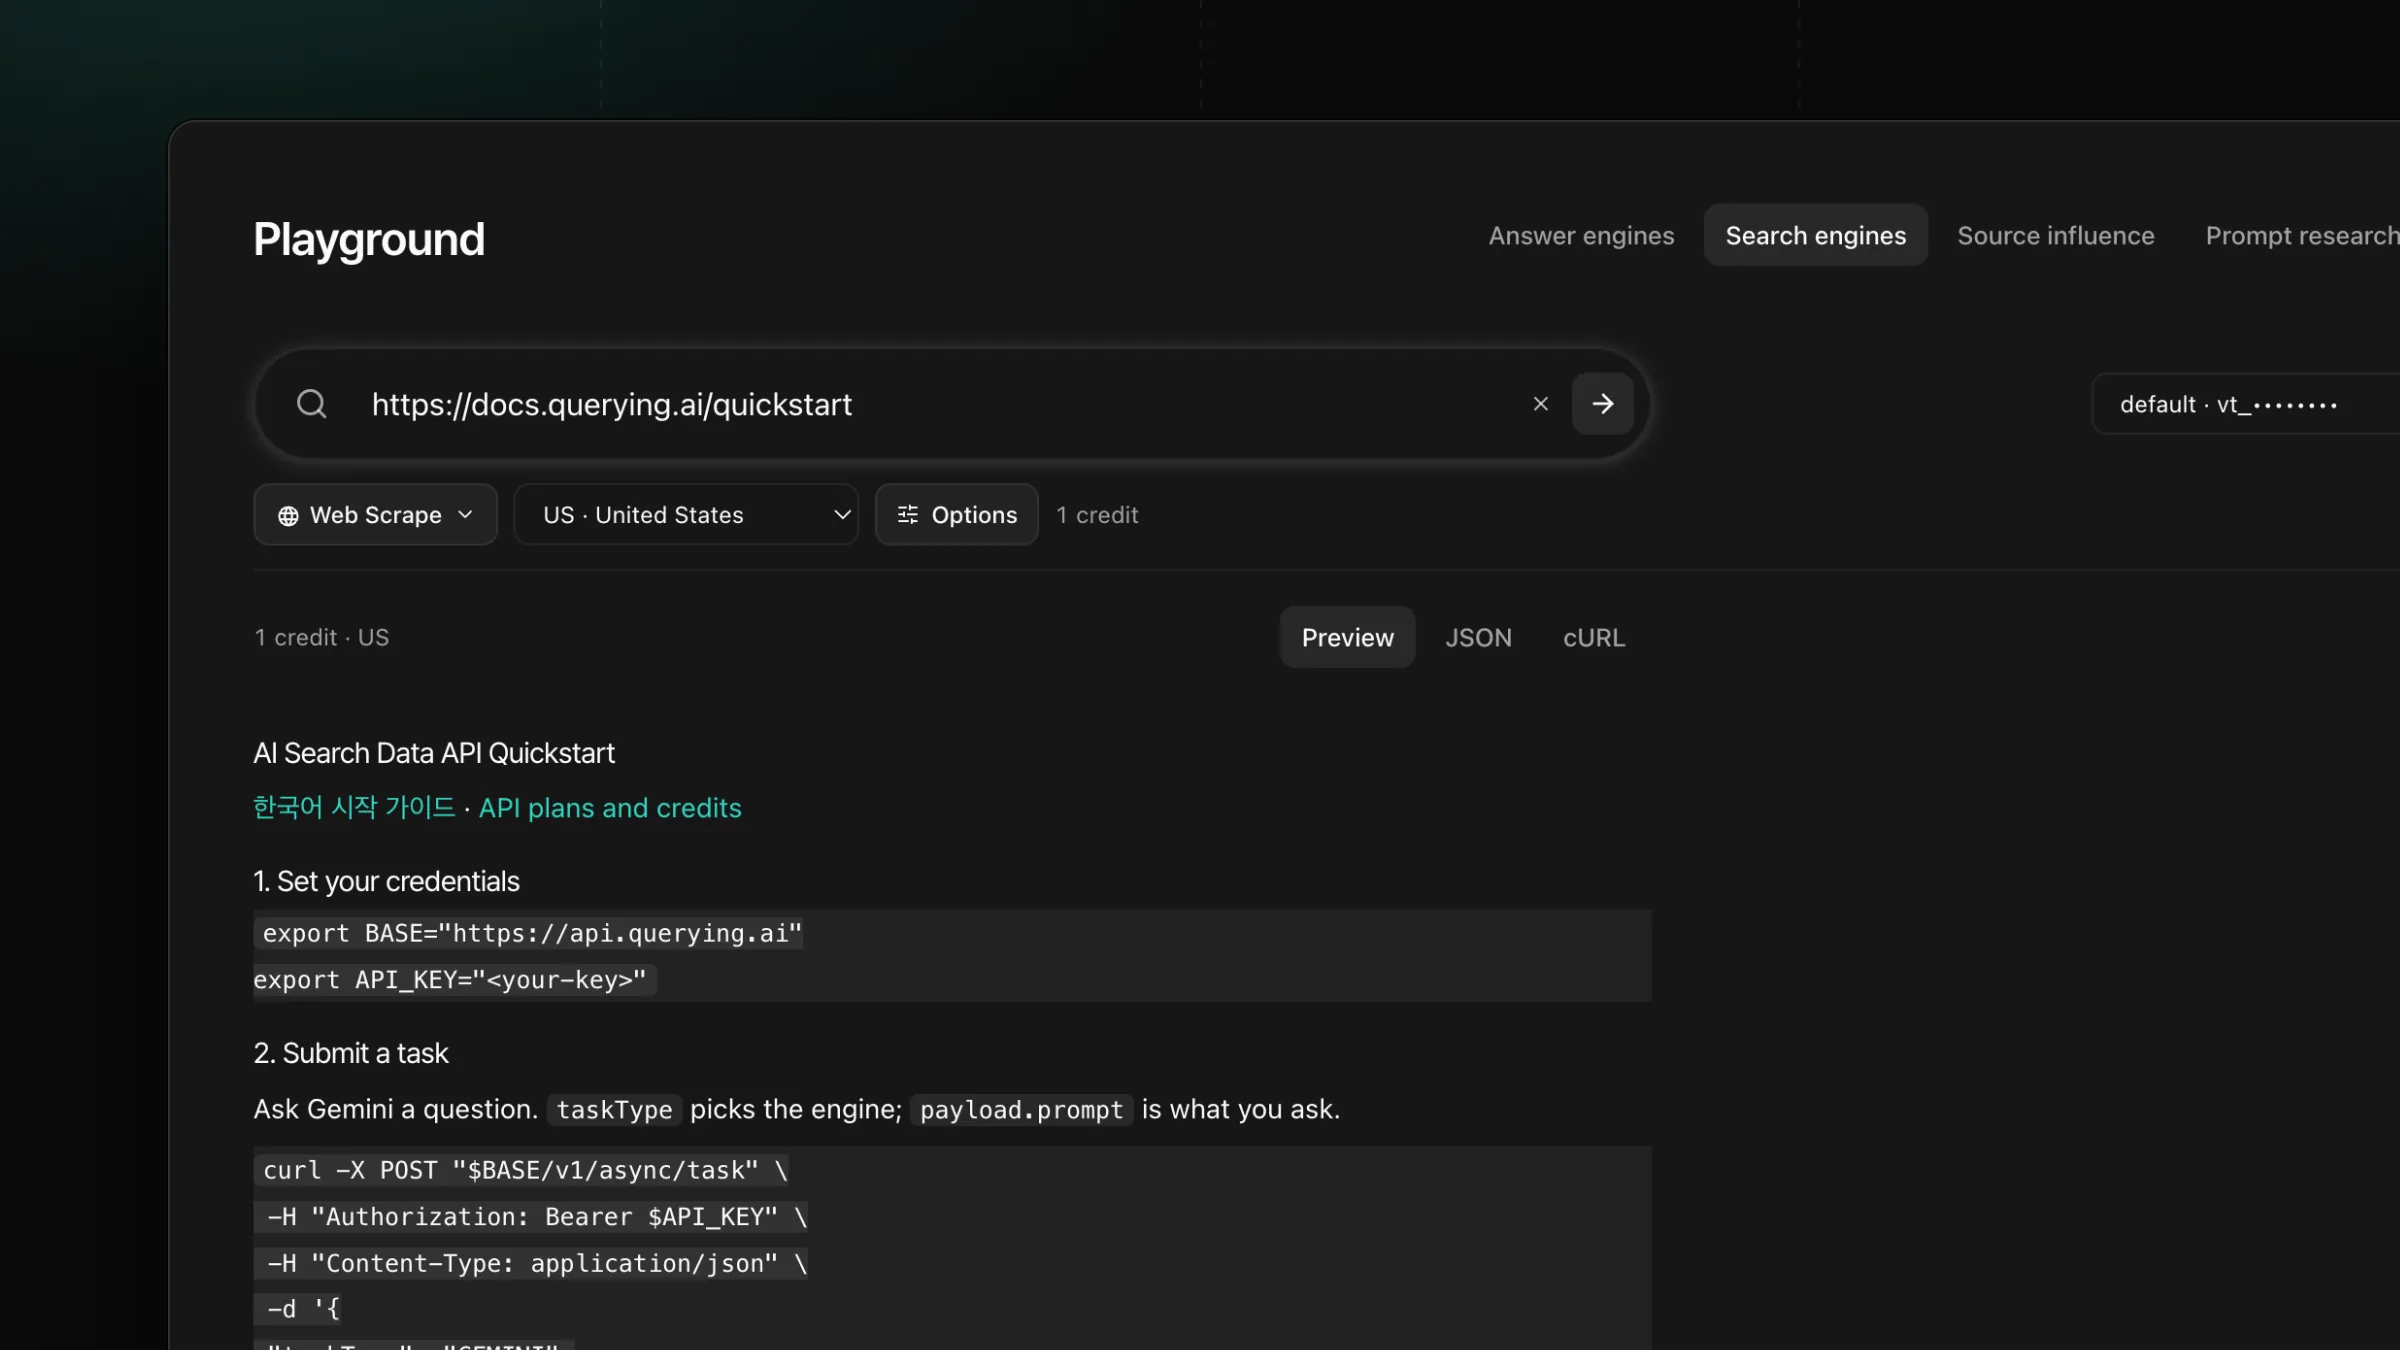
Web Scrape 将 URL 的主要内容提取为 Markdown,每个完成的请求消耗 1 个积分。
markdown:页面正文,保留标题、段落、列表、表格、链接和图片,并去掉网站的页眉、页脚和导航。title、description、author、publishedAt、siteName、language、image:页面声明的信息原样返回。finalUrl 和 statusCode:重定向后的最终地址,以及网站返回的状态码。images:markdown 中的图片,按出现顺序排列并附带替代文本。发送公开的 http 或 https URL,最长 2,048 个字符。Web Scrape 会打开页面,对购物网站商品页这类由脚本绘制的页面先完成渲染再读取,留下读者真正要看的正文、表格和图片。结果是干净的 Markdown,可以直接存储、检索和分析。
用 maxChars 设置长度,范围为 1,000 到 200,000 个字符(默认 100,000)。较长的页面会在段落边界截断,并标记 truncated: true。country(默认 US)决定请求页面时使用的语言和地区。PDF、返回 404 或 410 的页面以及拒绝请求的网站会以 PAGE_UNAVAILABLE 结束,消息中附带网站的响应。
GOOGLE_SERP 结果中的 link,阅读每个搜索词排名靠前的页面。scrape_page,在 AI 助手中直接读取页面。在 Authorization 请求头中带上 API 密钥发送请求。
curl -X POST https://api.querying.ai/v1/async/task \
  -H "Authorization: Bearer $QUERYING_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "taskType": "WEB_SCRAPE",
    "payload": {
      "url": "https://docs.querying.ai/quickstart",
      "country": "US"
    }
}'taskTypestring必填CHATGPT 或 GOOGLE。payload.urlstring必填payload.maxCharsintegermarkdown 的长度上限,1,000 到 200,000,默认 100,000。更长的页面在段落处结束并带上 truncated。payload.countrystringUS。webhook.urlstringidempotencyKeystring完成的任务如下所示,已截取部分内容。
{
  "success": true,
  "task": {
    "id": "910017b1-4fd5-4bc7-8895-bbe6b1b0d1df",
    "taskType": "WEB_SCRAPE",
    "status": "COMPLETED",
    "createdAt": "2026-10-02T15:48:34.088Z"
  },
  "credits": { "creditsToCharge": 1, "creditsCharged": 1 },
  "response": {
    "url": "https://docs.querying.ai/quickstart",
    "finalUrl": "https://docs.querying.ai/quickstart",
    "statusCode": 200,
    "title": "AI Search Data API Quickstart",
    "description": "Submit a task, receive a result — with webhooks or by polling.",
    "siteName": "querying.ai",
    "language": "en",
    "markdown": "# AI Search Data API Quickstart\n\n[한국어 시작 가이드](https://querying.ai/ko/guides/quickstart) · [API plans and credits](https://querying.ai/en/pricing)\n\n## 1\\. Set your credentials\n\n```shellscript\nexport BASE=\"https://api.querying.ai\"\nexport API_KEY=\"<your-key>\"\n```\n\n…",
    "images": [],
    "truncated": false
  }
}task.statusstringQUEUED、PROCESSING,最终为附带回答的 COMPLETED 或附带 error 的 FAILED。credits.creditsChargedintegerresponse.markdownstringresponse.titlestringdescription、author、siteName 和 language。response.publishedAtstringresponse.finalUrlstringstatusCode。response.imagesarraymarkdown 中的图片,按正文顺序排列,每张含 url 和 alt。response.truncatedbooleanmarkdown 达到 maxChars 并在段落处结束时为 true。请求会立即返回 status 为 QUEUED 的任务。用 GET /v1/async/task/{id} 轮询,直到 status 变为 COMPLETED 或 FAILED;或者加上 webhook.url,在服务器上接收同样的 task、credits 和 response。任务结束后,结果保留 24 小时供查询。
curl https://api.querying.ai/v1/async/task/$TASK_ID \
-H "Authorization: Bearer $QUERYING_API_KEY"每个完成的页面消耗 1 个积分。
在 CHATGPT、GEMINI 和 GOOGLE 任务中将 country 设为 CN 或 HK,即可获得中国大陆和香港用户看到的回答。
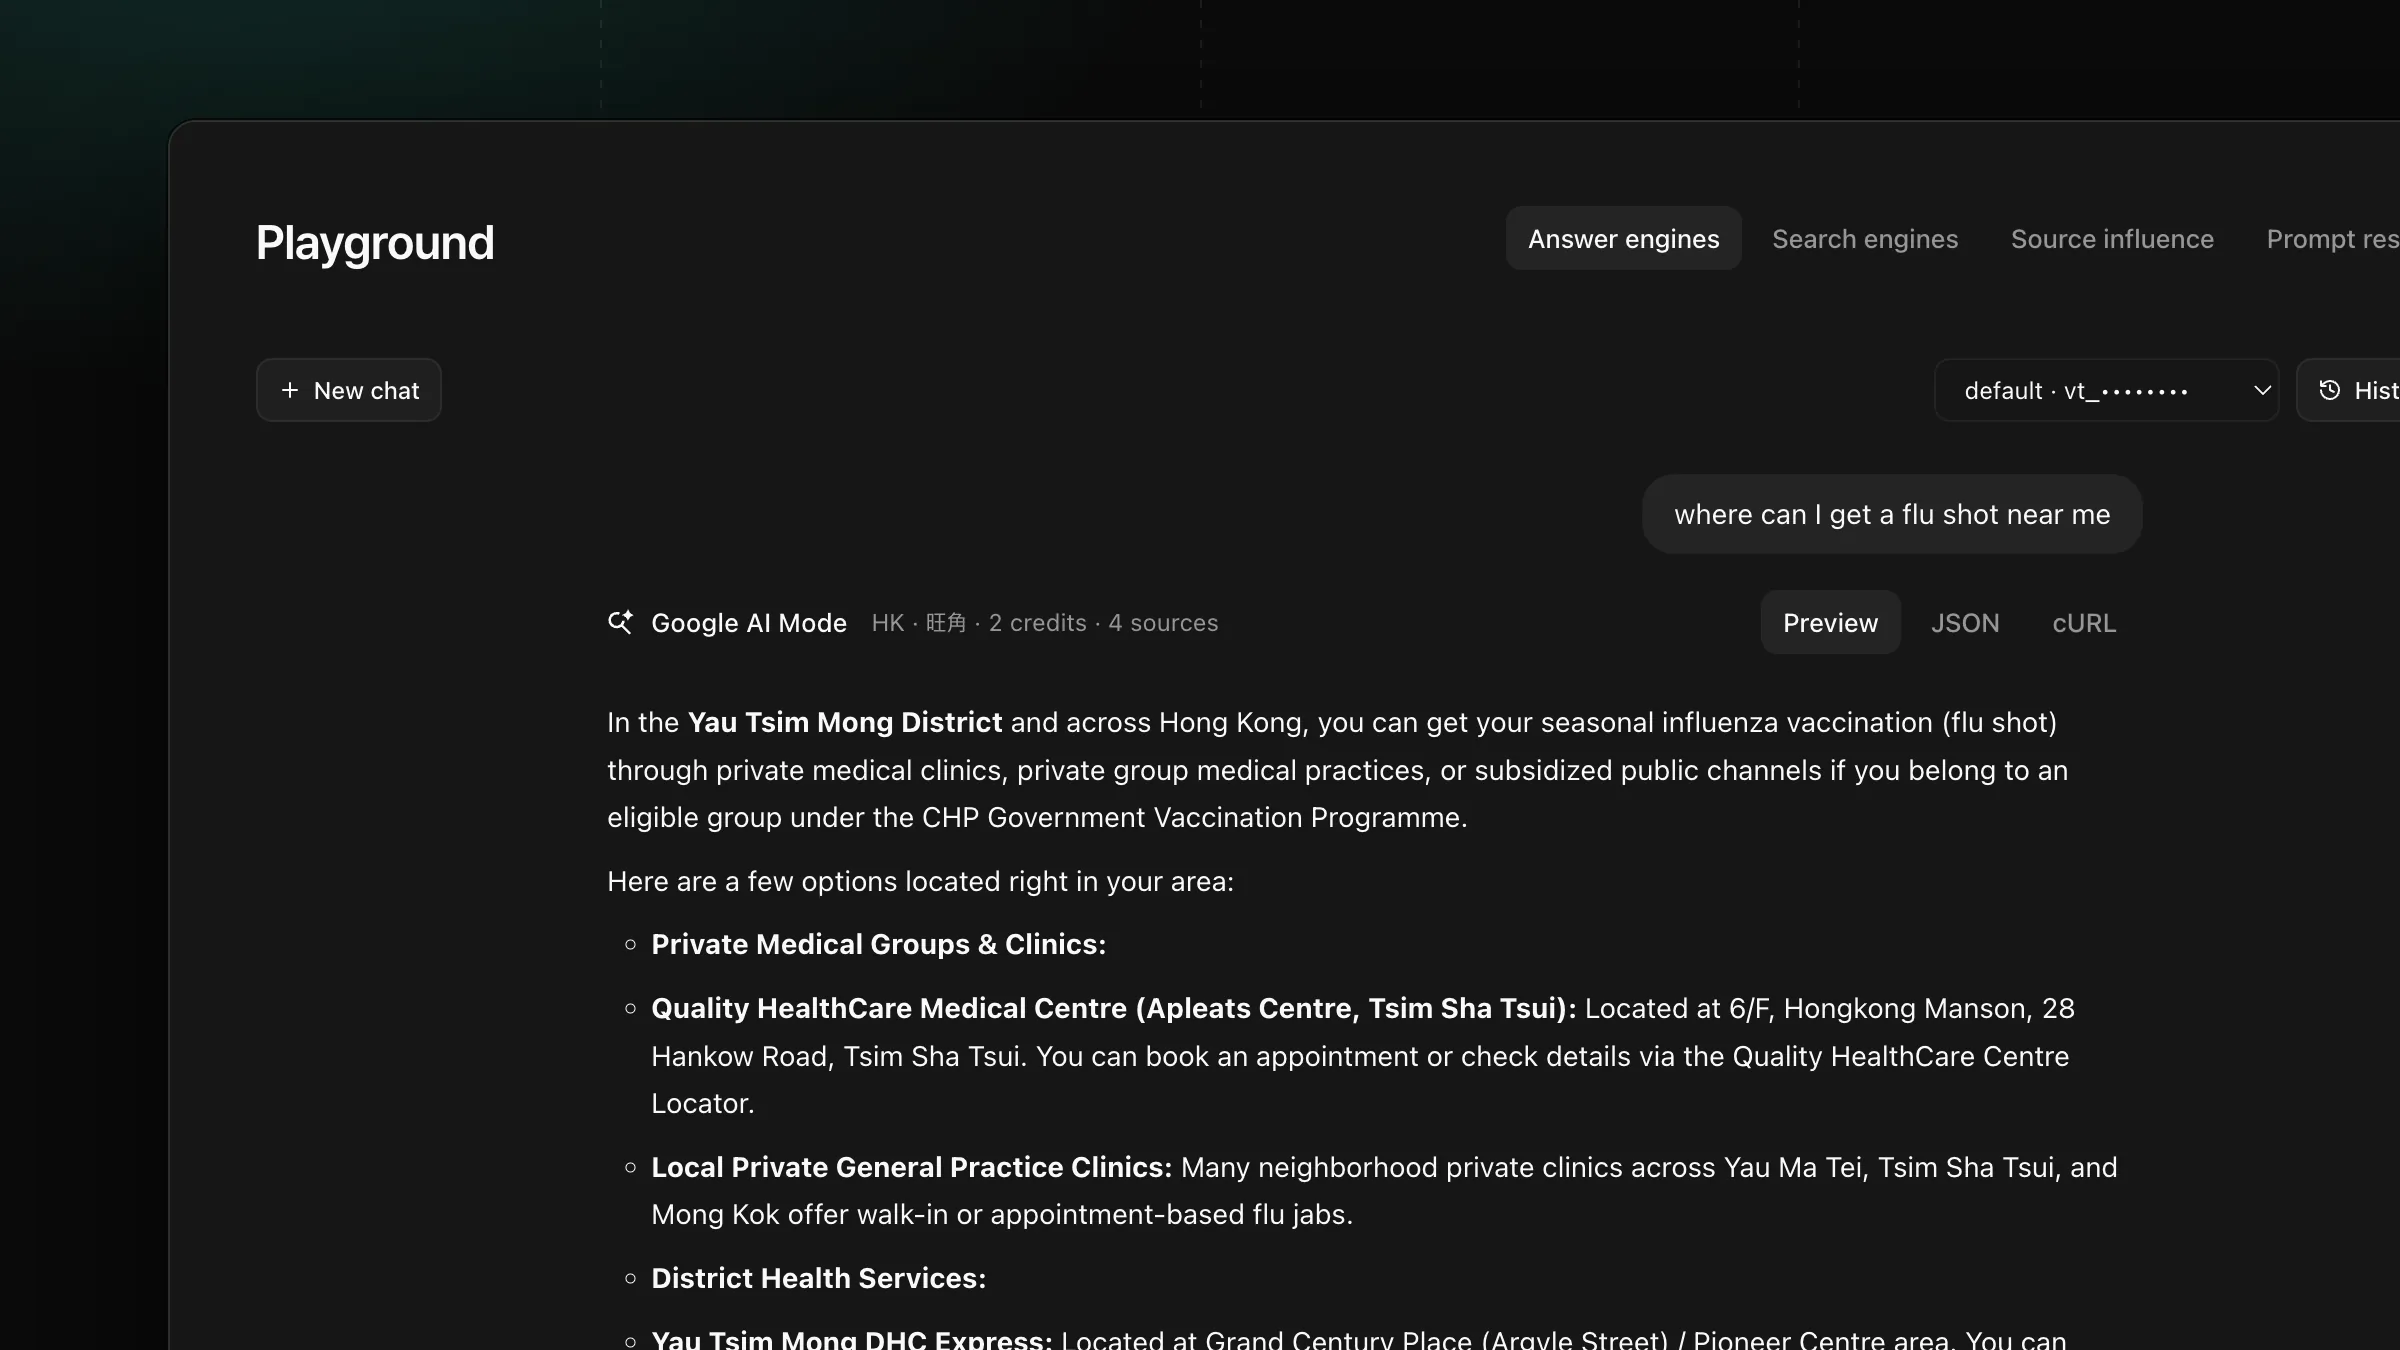
在 GOOGLE、AIMODE 和 GOOGLE_SERP 任务中设置 payload.location,即可获得身处该地点的用户看到的 AI Overview、AI Mode 回答和搜索结果。
通过邮件接收产品更新。