답변 30개로 잰 언급률의 오차 범위는 약 ±18%p입니다. AI 노출을 재고 두 기간을 비교하는 데 필요한 질문, 엔진, 실행 횟수를 계산식과 함께 정리했습니다.
AI 노출 측정에 표본이 필요한 이유
AI 답변은 매번 새로 뽑힙니다. 같은 구매 질문도 실행할 때마다 답변에 나오는 브랜드, 순서, 출처가 달라집니다. 언급률은 우리 브랜드를 언급한 답변의 비율이므로, 다른 측정 비율처럼 표본 오차가 있습니다. 측정한 비율은 실제 비율 근처에 있고, 얼마나 가까운지는 답변 수가 정합니다.
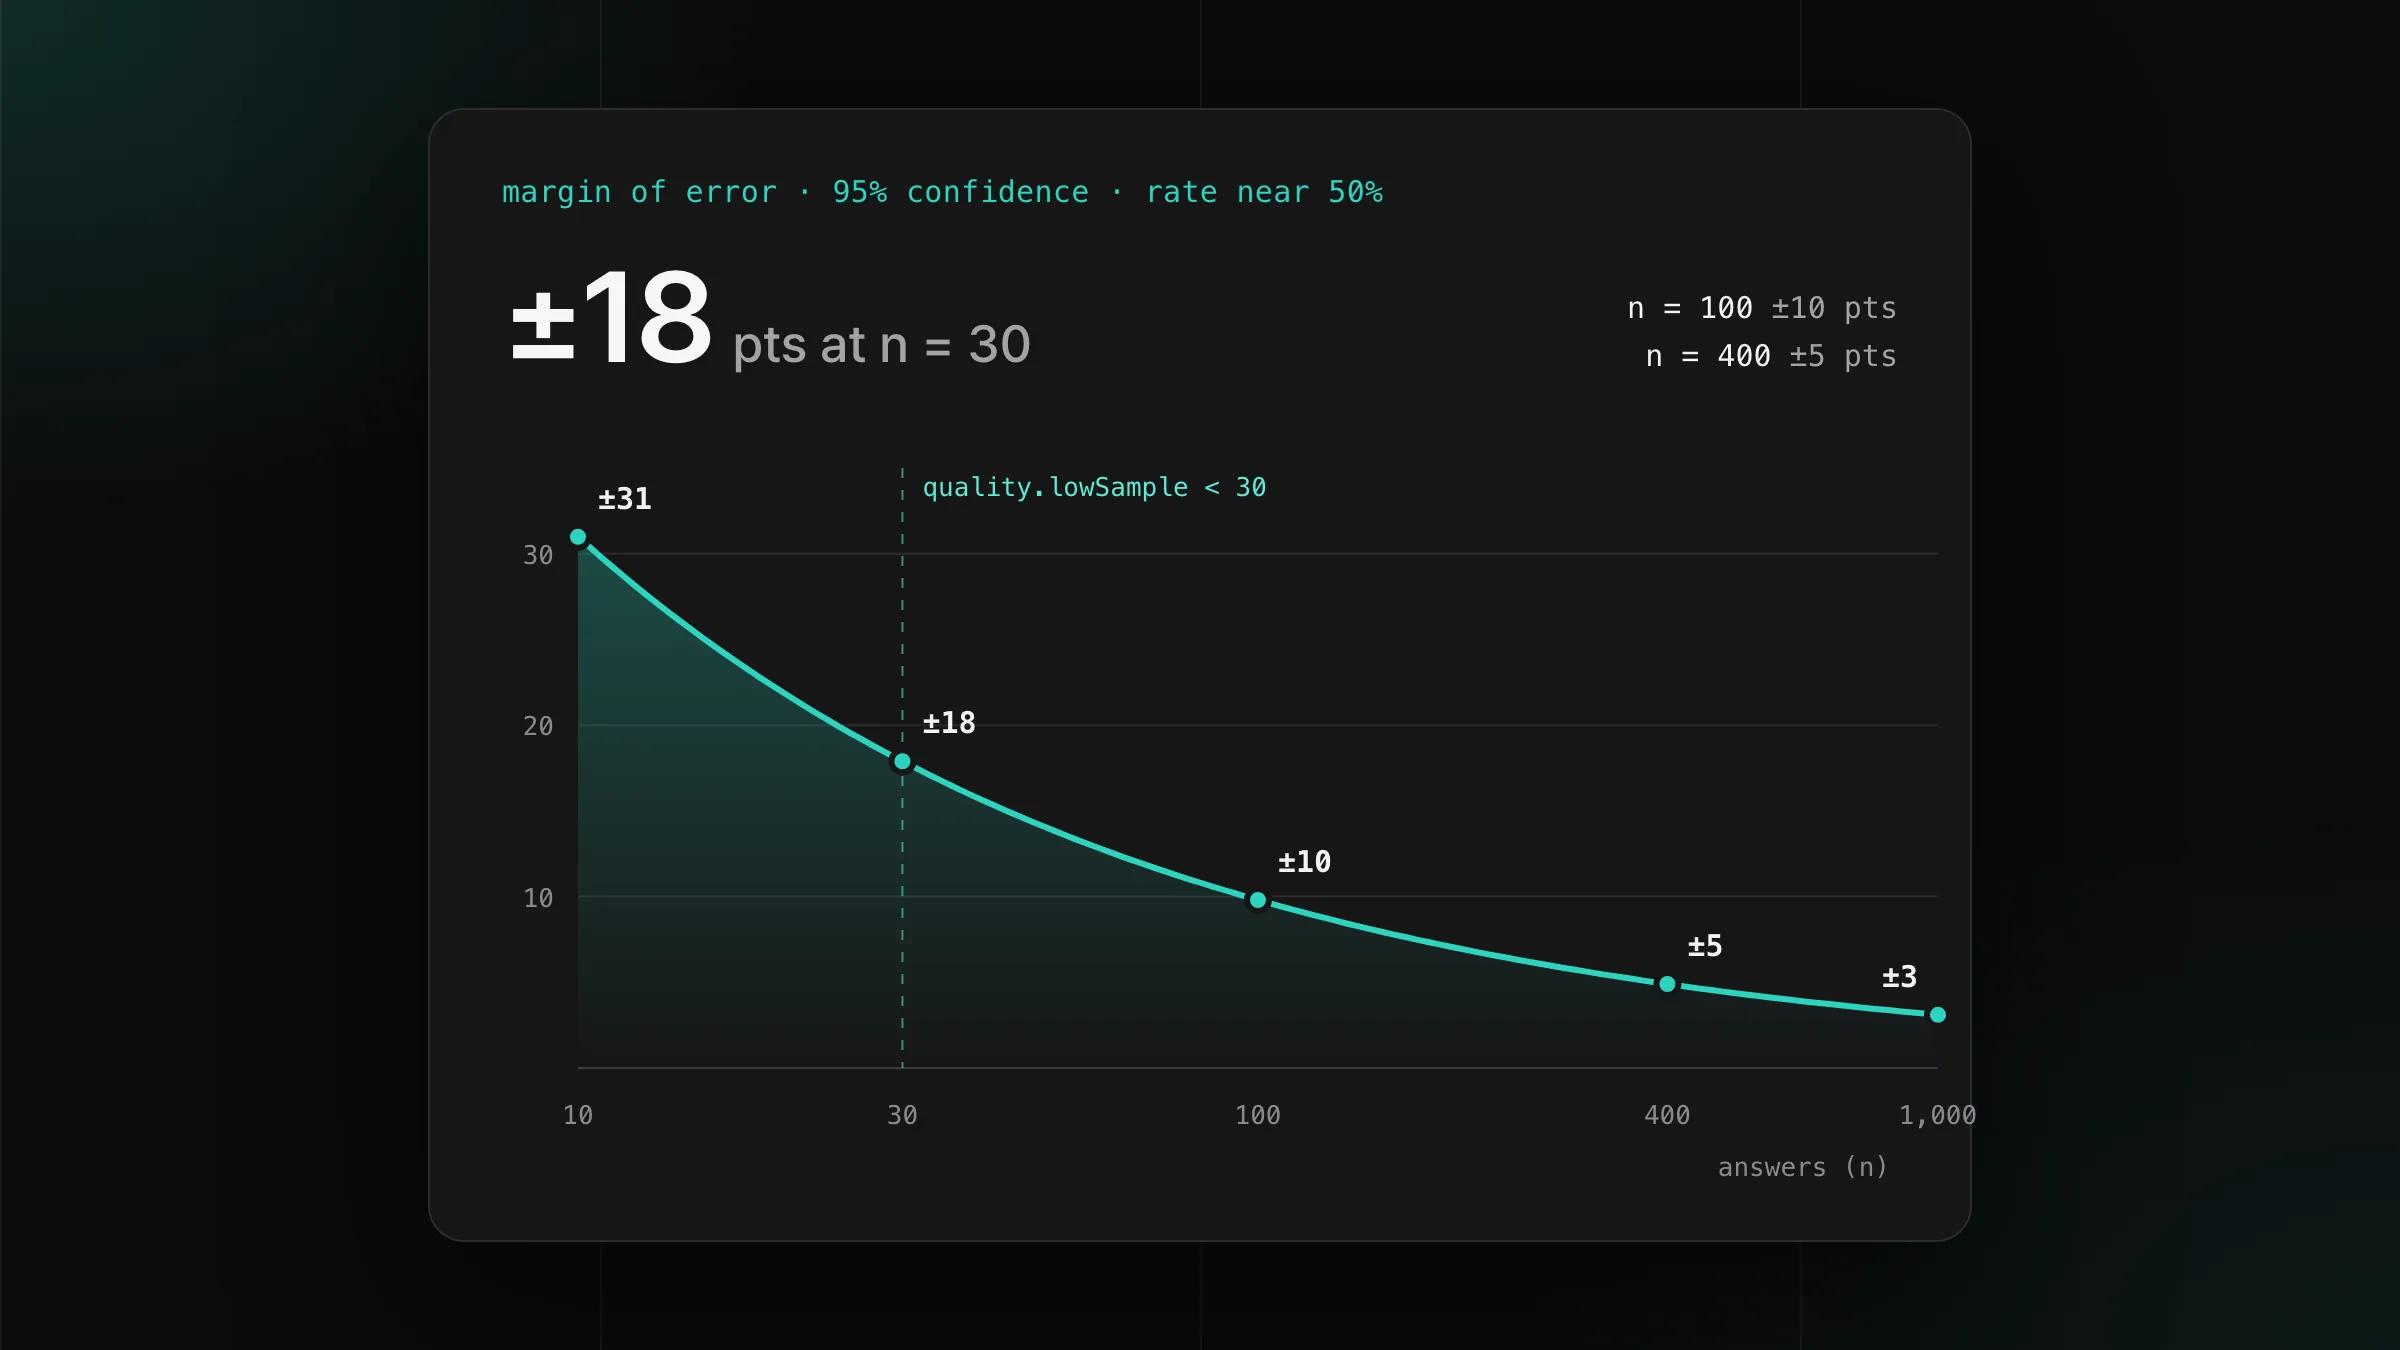
오차 범위가 그 거리를 알려 줍니다. 답변 n개로 잰 비율 p는 95% 신뢰수준에서 실제 비율과 다음 값 이내에 있습니다.
margin = 1.96 * sqrt(p * (1 - p) / n) * 100오차 범위는 비율이 50% 근처일 때 가장 넓으므로 아래 표는 50%를 기준으로 계획합니다. 비율이 20%라면 모든 오차 범위가 5분의 1만큼 줄어듭니다.
답변 수별 오차 범위
| 답변 수 | 오차 범위 | 예시 |
|---|---|---|
| 10 | ±31%p | 질문 1개, 엔진 1개, 10회 실행 |
| 21 | ±21%p | AI 인덱스에서 가장 작은 카테고리, 미국 러닝화 |
| 30 | ±18%p | 모니터가 quality.lowSample로 표시하는 기준 |
| 71 | ±12%p | AI 인덱스의 한국 엔진 하나 |
| 100 | ±10%p | 질문 20개 × 엔진 1개 × 5회 실행 |
| 200 | ±7%p | 질문 20개 × 엔진 2개 × 5회 실행 |
| 400 | ±5%p | 질문 20개 × 엔진 4개 × 5회 실행 |
| 479 | ±4.5%p | AI 인덱스 전체 답변, 모든 엔진과 시장 |
| 1,000 | ±3%p | 질문 20개 × 엔진 5개 × 10회 실행 |
AI 인덱스에서 이 표가 그대로 보입니다. 한국 ChatGPT의 61%는 답변 71개에서 나왔고 구간은 49-71%입니다. 답변 479개 전체의 82%는 79-85%로 훨씬 단단합니다. 카테고리 순위는 카테고리마다 답변 21-48개에서 나오므로, 한 카테고리 안에서 몇 %p 차이 나는 두 브랜드는 동률입니다.
0%와 100% 근처의 비율
양 끝에서는 단순한 공식이 오차 범위를 0으로 계산합니다. 답변 30개에서 언급이 0회면 오차 범위가 0이지만, 전체 답변의 5%에서 언급되는 브랜드도 답변 30개짜리 표본 다섯 번 중 한 번은 언급 0회를 받습니다.
Wilson 구간은 양 끝에서도 정확하며, AI 인덱스가 이 구간을 공개합니다. 답변 30개 중 언급 0회의 95% 구간은 0-11%입니다. 미국 러닝화 답변 21개 모두에 나온 On의 구간은 85-100%입니다.
두 기간 비교하기
두 기간 사이의 변화에는 두 기간의 잡음이 모두 들어갑니다. 기간마다 답변이 100개면, 실제 비율이 같은 두 기간도 100번 중 95번은 최대 14%p까지 차이가 납니다. 답변 100개짜리 두 주 사이의 10%p 변동은 이 범위 안에 있습니다.
| 확인할 변화 | 기간마다 필요한 답변 |
|---|---|
| 25%p | 약 65개 |
| 20%p | 약 100개 |
| 15%p | 약 175개 |
| 10%p | 약 400개 |
| 5%p | 약 1,600개 |
이 수치는 비율이 50% 근처일 때 95% 신뢰수준에서 변화를 80% 확률로 잡아내는 기준입니다. 모니터는 같은 질문과 엔진으로 이번 기간과 직전 기간을 비교하고, 두 기간을 비교할 수 있을 때 변화값을 보여 줍니다. 한 기간에 답변이 없거나 두 기간 사이에 채점 기준이 바뀌면 quality.comparable이 false가 됩니다.
답변 수를 만드는 방법
기간의 답변 수 = 질문 수 × 엔진 수 × 실행 횟수입니다. 질문 20개를 ChatGPT, Gemini, Perplexity에 매일 실행하는 모니터는 하루 60개, 일주일 420개, 엔진마다 140개를 모읍니다. 엔진별로 일주일에 ±8%p, 30일이면 ±4%p입니다.
ChatGPT는 태스크당 2크레딧, Gemini와 Perplexity는 1크레딧이므로 이 모니터는 실행당 80크레딧, 매일 실행하면 한 달에 약 2,400크레딧입니다. 요금제별 크레딧은 요금에서 확인하세요.
- 표본을 여러 질문에 나눕니다. 같은 질문의 답변끼리는 서로 닮아서, 같은 질문을 더 자주 실행하는 것보다 질문을 늘리는 쪽이 비율을 더 빨리 단단하게 만듭니다.
- 전체 비율을 먼저 읽고, 그다음 엔진별, 마지막으로 질문별로 읽습니다. 나눌수록 답변이 줄고 오차 범위가 넓어집니다.
- 목표 답변 수에 닿을 만큼 기간을 잡습니다. 큰 모니터는 1주, 작은 모니터는 30일이 맞습니다.
- 비교하는 기간 동안 질문, 엔진, 별칭을 고정해 두 기간이 같은 것을 재게 합니다.
AI 노출 수치를 보고하는 방법
- 비율과 함께 답변 수를 적습니다. “답변 71개 중 61%”라고 쓰면 읽는 사람이 수치가 얼마나 단단한지 압니다.
- 수치로 결정을 내릴 때는 구간을 덧붙입니다. “61%(49-71%)”처럼 씁니다.
- 오차 범위보다 작은 차이는 브랜드 사이든 기간 사이든 동률로 읽습니다.
- 의외의 수치가 나오면 그 뒤의 답변을 열어 어떤 질문과 엔진이 수치를 움직였는지 확인합니다.
자주 묻는 질문
AI 노출을 재려면 답변이 몇 개 필요한가요?
읽으려는 비율마다 기간당 채점한 답변 30개 이상이 필요하고, 이때 오차 범위는 약 ±18%p입니다. 답변 100개면 ±10%p, 400개면 ±5%p입니다. 두 기간을 비교하려면 20%p 변화에는 기간마다 약 100개, 10%p 변화에는 약 400개가 필요합니다.
모니터에 질문을 몇 개 넣어야 하나요?
질문 수 × 엔진 수 × 실행 횟수가 기간마다 목표 답변 수에 닿을 만큼 넣습니다. 질문 20개를 엔진 3개에 매일 실행하면 엔진마다 일주일에 140개가 쌓입니다. 같은 질문을 더 자주 실행하는 것보다 질문을 늘리는 쪽이 비율을 더 빨리 단단하게 만듭니다.
이번 주 언급률은 왜 바뀌었나요?
모든 변화에는 표본 잡음이 섞여 있습니다. 주마다 답변이 100개면, 실제 비율이 같은 두 주도 100번 중 95번은 최대 14%p까지 차이가 납니다. 더 긴 기간을 비교하거나 질문을 늘리고, 변화 뒤의 답변을 열어 보세요.
querying.ai는 어떤 신뢰수준을 쓰나요?
일반적인 기준인 95%를 씁니다. AI 인덱스는 95% Wilson 구간을 공개하고, 모니터는 모든 기간의 표본 크기를 공개합니다.