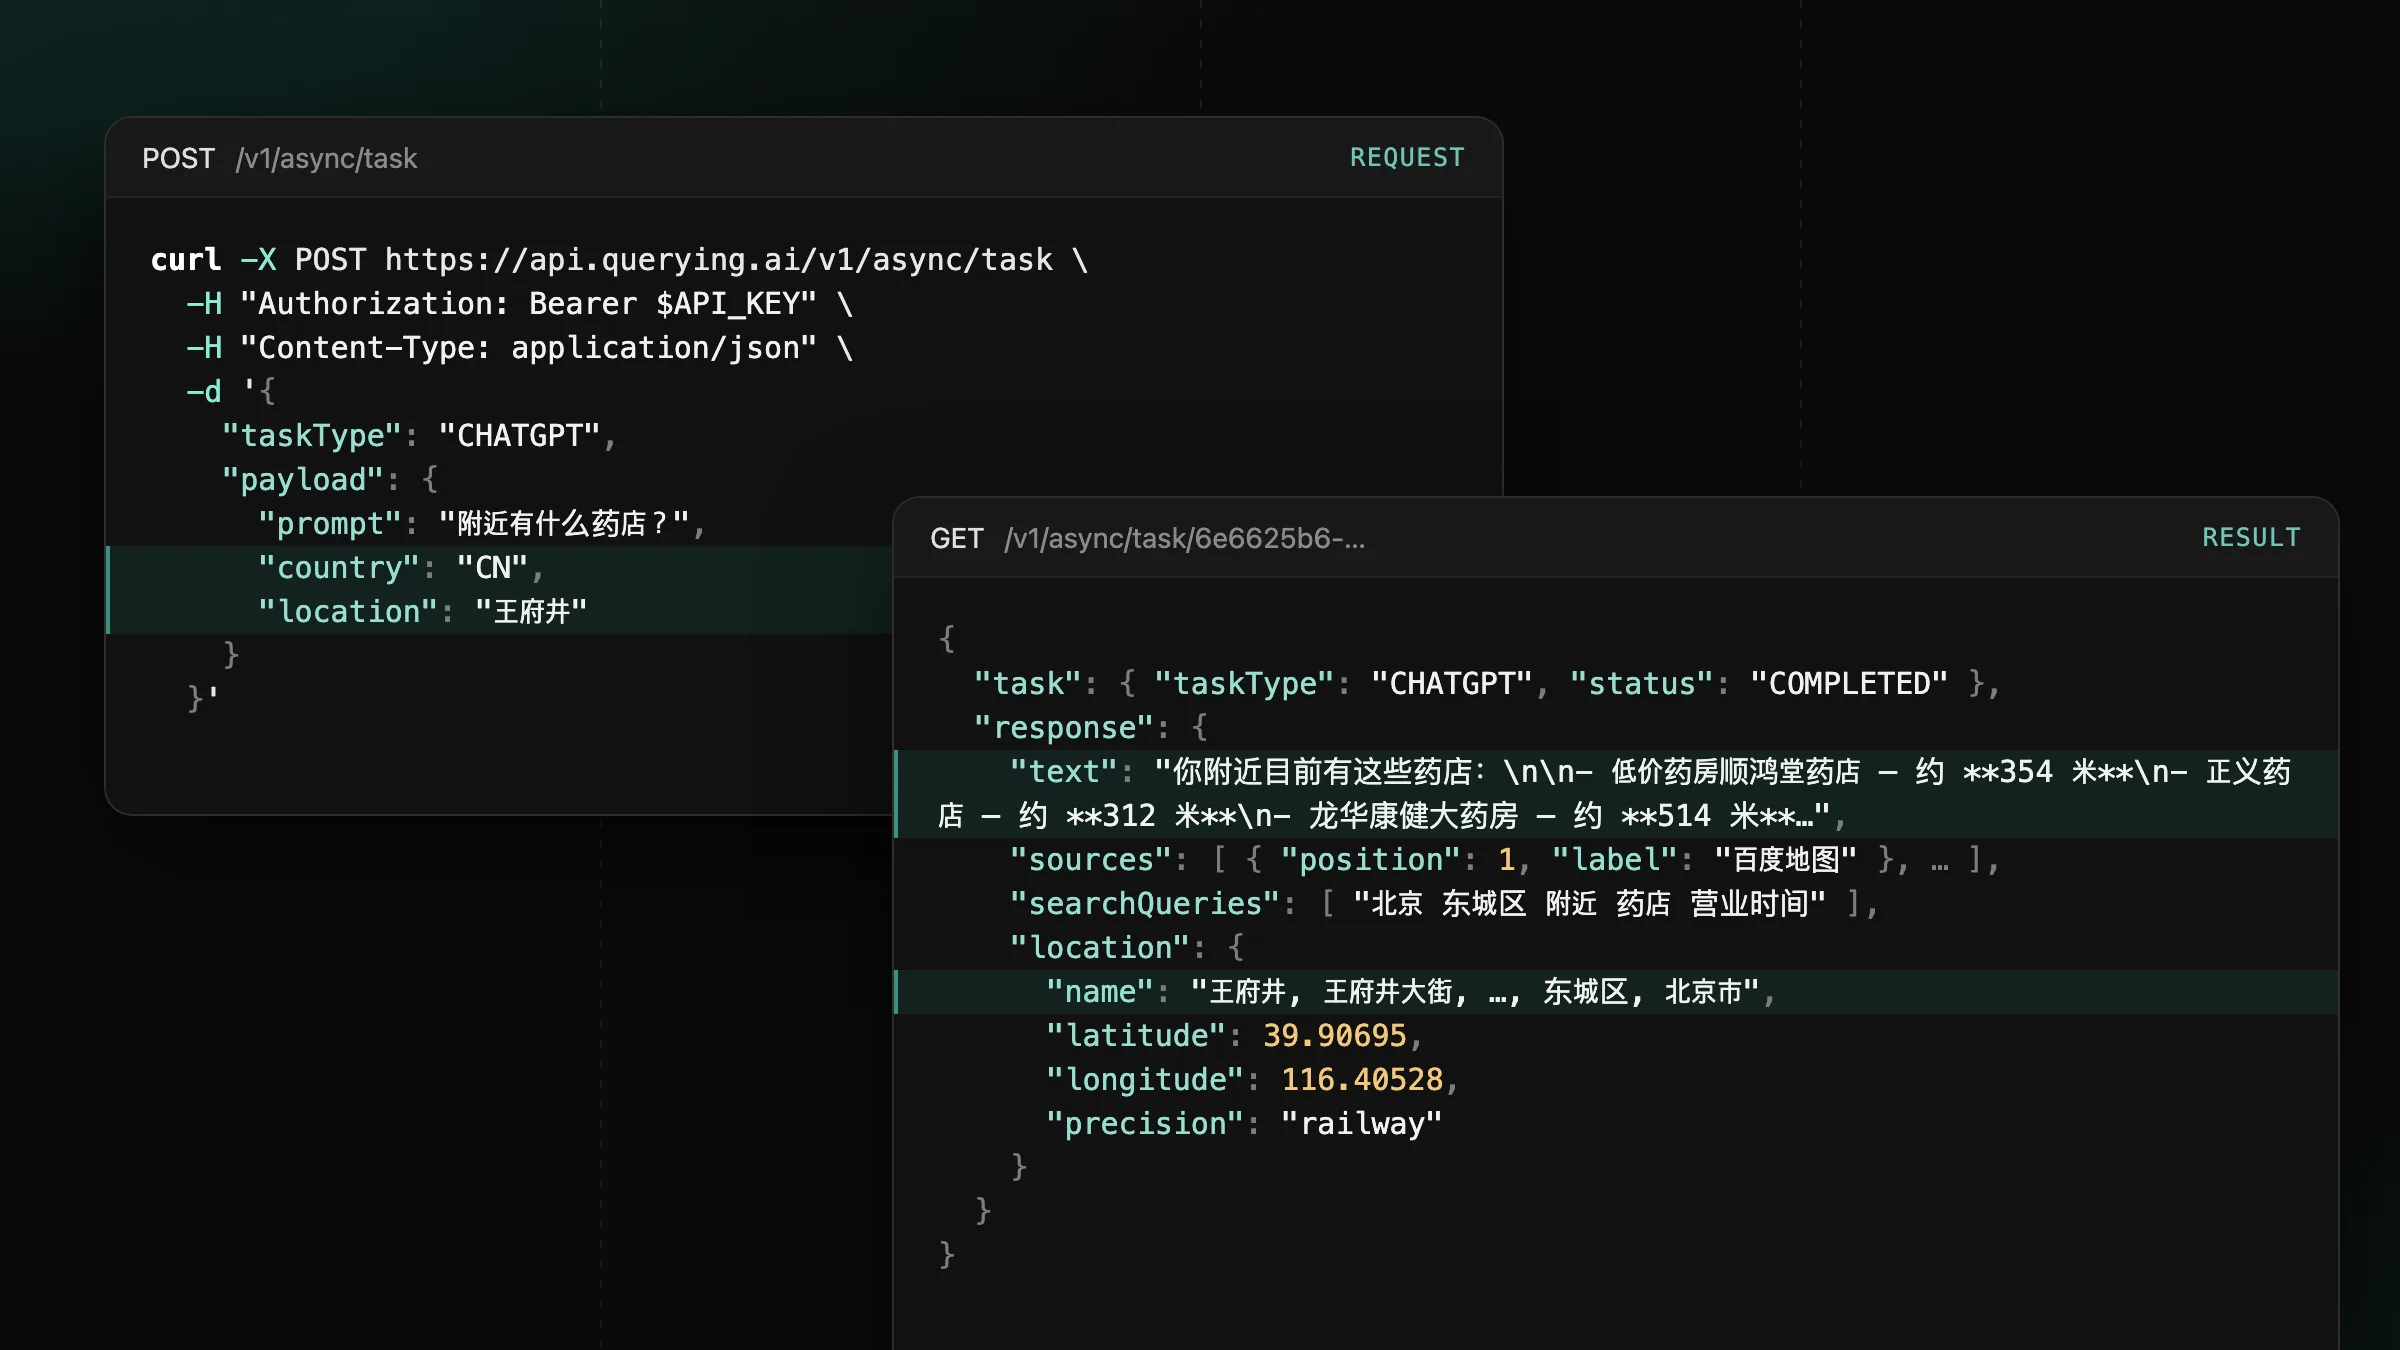
A China continental já está disponível no ChatGPT, no Gemini e no Google
Use country CN ou HK em tarefas CHATGPT, GEMINI e GOOGLE para receber as respostas que os usuários da China continental e de Hong Kong veem.
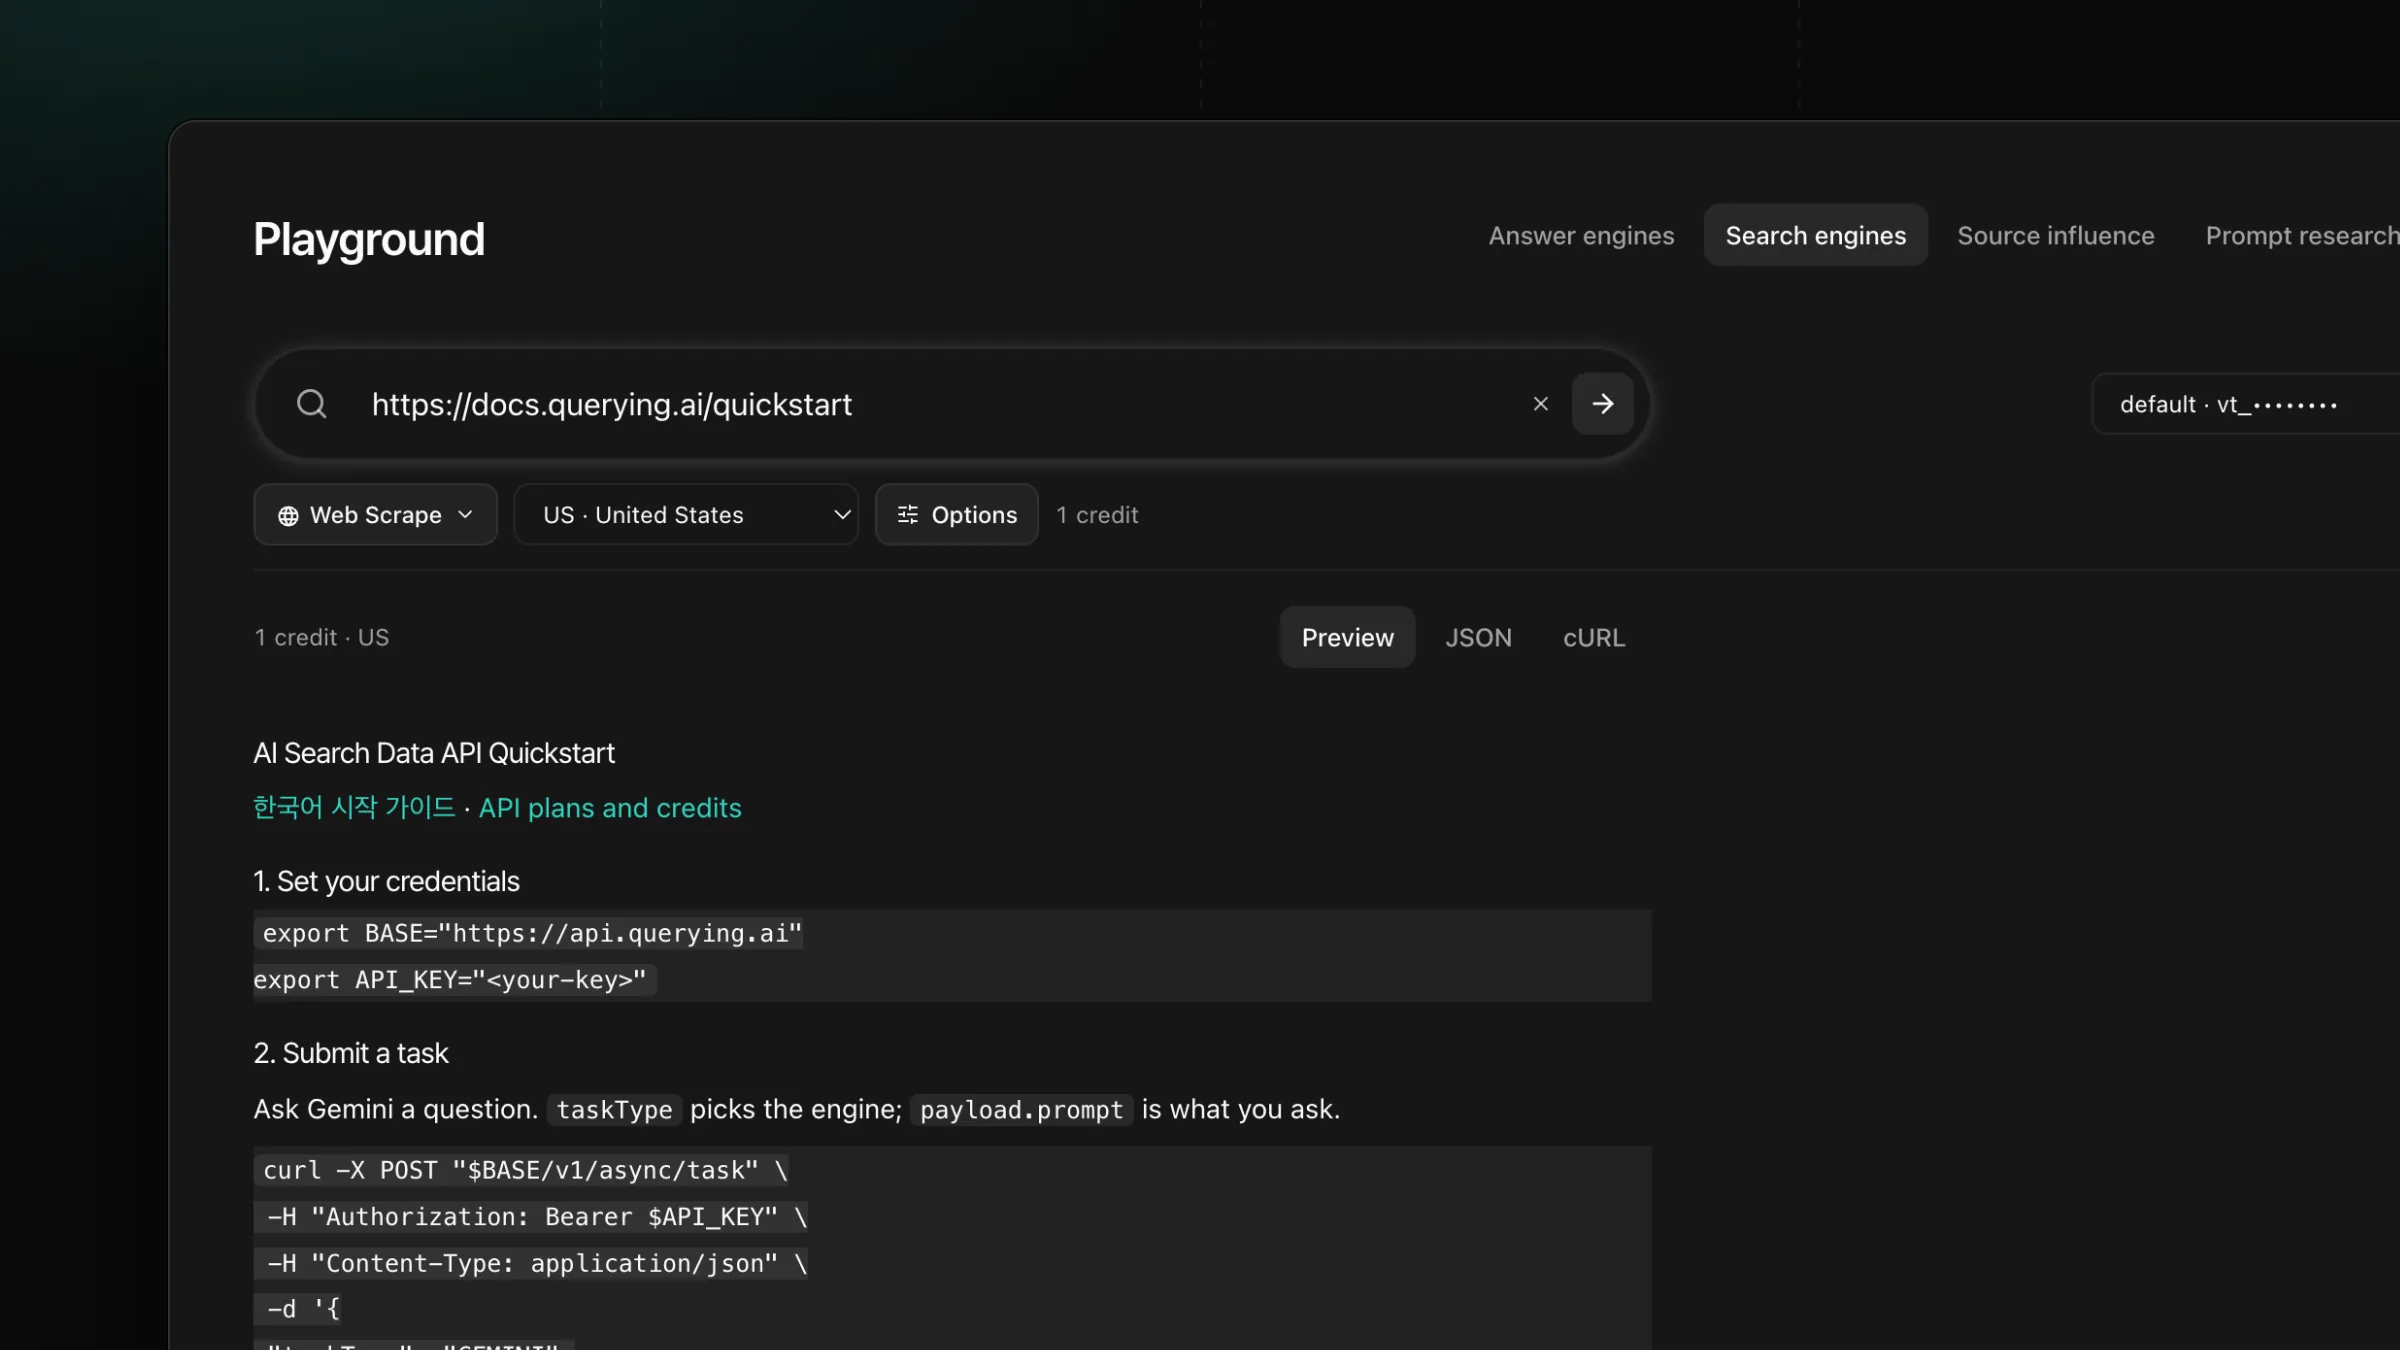
Web Scrape extrai o conteúdo principal de uma URL em Markdown por 1 crédito por solicitação concluída.
markdown: o conteúdo principal da página com títulos, parágrafos, listas, tabelas, links e imagens, e com o cabeçalho, o rodapé e a navegação do site removidos.title, description, author, publishedAt, siteName, language e image quando a página os declara.finalUrl e statusCode: o endereço final depois dos redirecionamentos e o status que o site devolveu.images: cada imagem de markdown, na ordem em que aparece, com o texto alternativo.Envie uma URL pública http ou https com até 2.048 caracteres. O Web Scrape abre a página, renderiza as que um script desenha, como páginas de produto de lojas, e guarda o conteúdo que o leitor procura: o texto, as tabelas e as imagens. O resultado é um Markdown limpo, pronto para guardar, buscar ou analisar.
maxChars define o tamanho, de 1.000 a 200.000 caracteres (100.000 por padrão). Uma página longa para em uma quebra de parágrafo e marca truncated: true. country (US por padrão) define o idioma e a região com que a página é pedida. Um PDF, uma página que responde 404 ou 410, ou um site que recusa a solicitação encerram a tarefa com PAGE_UNAVAILABLE, e a mensagem traz a resposta do site.
link dos resultados do GOOGLE_SERP para ler as páginas que ranqueiam em uma busca.scrape_page.Envie a requisição com a sua chave de API no cabeçalho Authorization.
curl -X POST https://api.querying.ai/v1/async/task \
  -H "Authorization: Bearer $QUERYING_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "taskType": "WEB_SCRAPE",
    "payload": {
      "url": "https://docs.querying.ai/quickstart",
      "country": "US"
    }
}'taskTypestringObrigatórioCHATGPT ou GOOGLE.payload.urlstringObrigatóriopayload.maxCharsintegermarkdown, de 1.000 a 200.000. Padrão 100.000. Uma página maior termina numa quebra de parágrafo e traz truncated.payload.countrystringUS.webhook.urlstringidempotencyKeystringUma tarefa concluída chega assim, resumida para facilitar a leitura.
{
  "success": true,
  "task": {
    "id": "910017b1-4fd5-4bc7-8895-bbe6b1b0d1df",
    "taskType": "WEB_SCRAPE",
    "status": "COMPLETED",
    "createdAt": "2026-10-02T15:48:34.088Z"
  },
  "credits": { "creditsToCharge": 1, "creditsCharged": 1 },
  "response": {
    "url": "https://docs.querying.ai/quickstart",
    "finalUrl": "https://docs.querying.ai/quickstart",
    "statusCode": 200,
    "title": "AI Search Data API Quickstart",
    "description": "Submit a task, receive a result — with webhooks or by polling.",
    "siteName": "querying.ai",
    "language": "en",
    "markdown": "# AI Search Data API Quickstart\n\n[한국어 시작 가이드](https://querying.ai/ko/guides/quickstart) · [API plans and credits](https://querying.ai/en/pricing)\n\n## 1\\. Set your credentials\n\n```shellscript\nexport BASE=\"https://api.querying.ai\"\nexport API_KEY=\"<your-key>\"\n```\n\n…",
    "images": [],
    "truncated": false
  }
}task.statusstringQUEUED, PROCESSING e, no fim, COMPLETED com a resposta ou FAILED com error.credits.creditsChargedintegerresponse.markdownstringresponse.titlestringdescription, author, siteName e language quando a página os declara.response.publishedAtstringresponse.finalUrlstringstatusCode.response.imagesarraymarkdown, na ordem de leitura, cada uma com url e alt.response.truncatedbooleantrue quando markdown chegou a maxChars e termina numa quebra de parágrafo.A requisição devolve a tarefa na hora, com status QUEUED. Consulte GET /v1/async/task/{id} até status virar COMPLETED ou FAILED, ou adicione webhook.url e a tarefa concluída chega ao seu servidor com os mesmos task, credits e response. Os resultados ficam disponíveis por 24 horas após o fim da tarefa.
curl https://api.querying.ai/v1/async/task/$TASK_ID \
-H "Authorization: Bearer $QUERYING_API_KEY"Cada página concluída usa 1 crédito.
Use country CN ou HK em tarefas CHATGPT, GEMINI e GOOGLE para receber as respostas que os usuários da China continental e de Hong Kong veem.
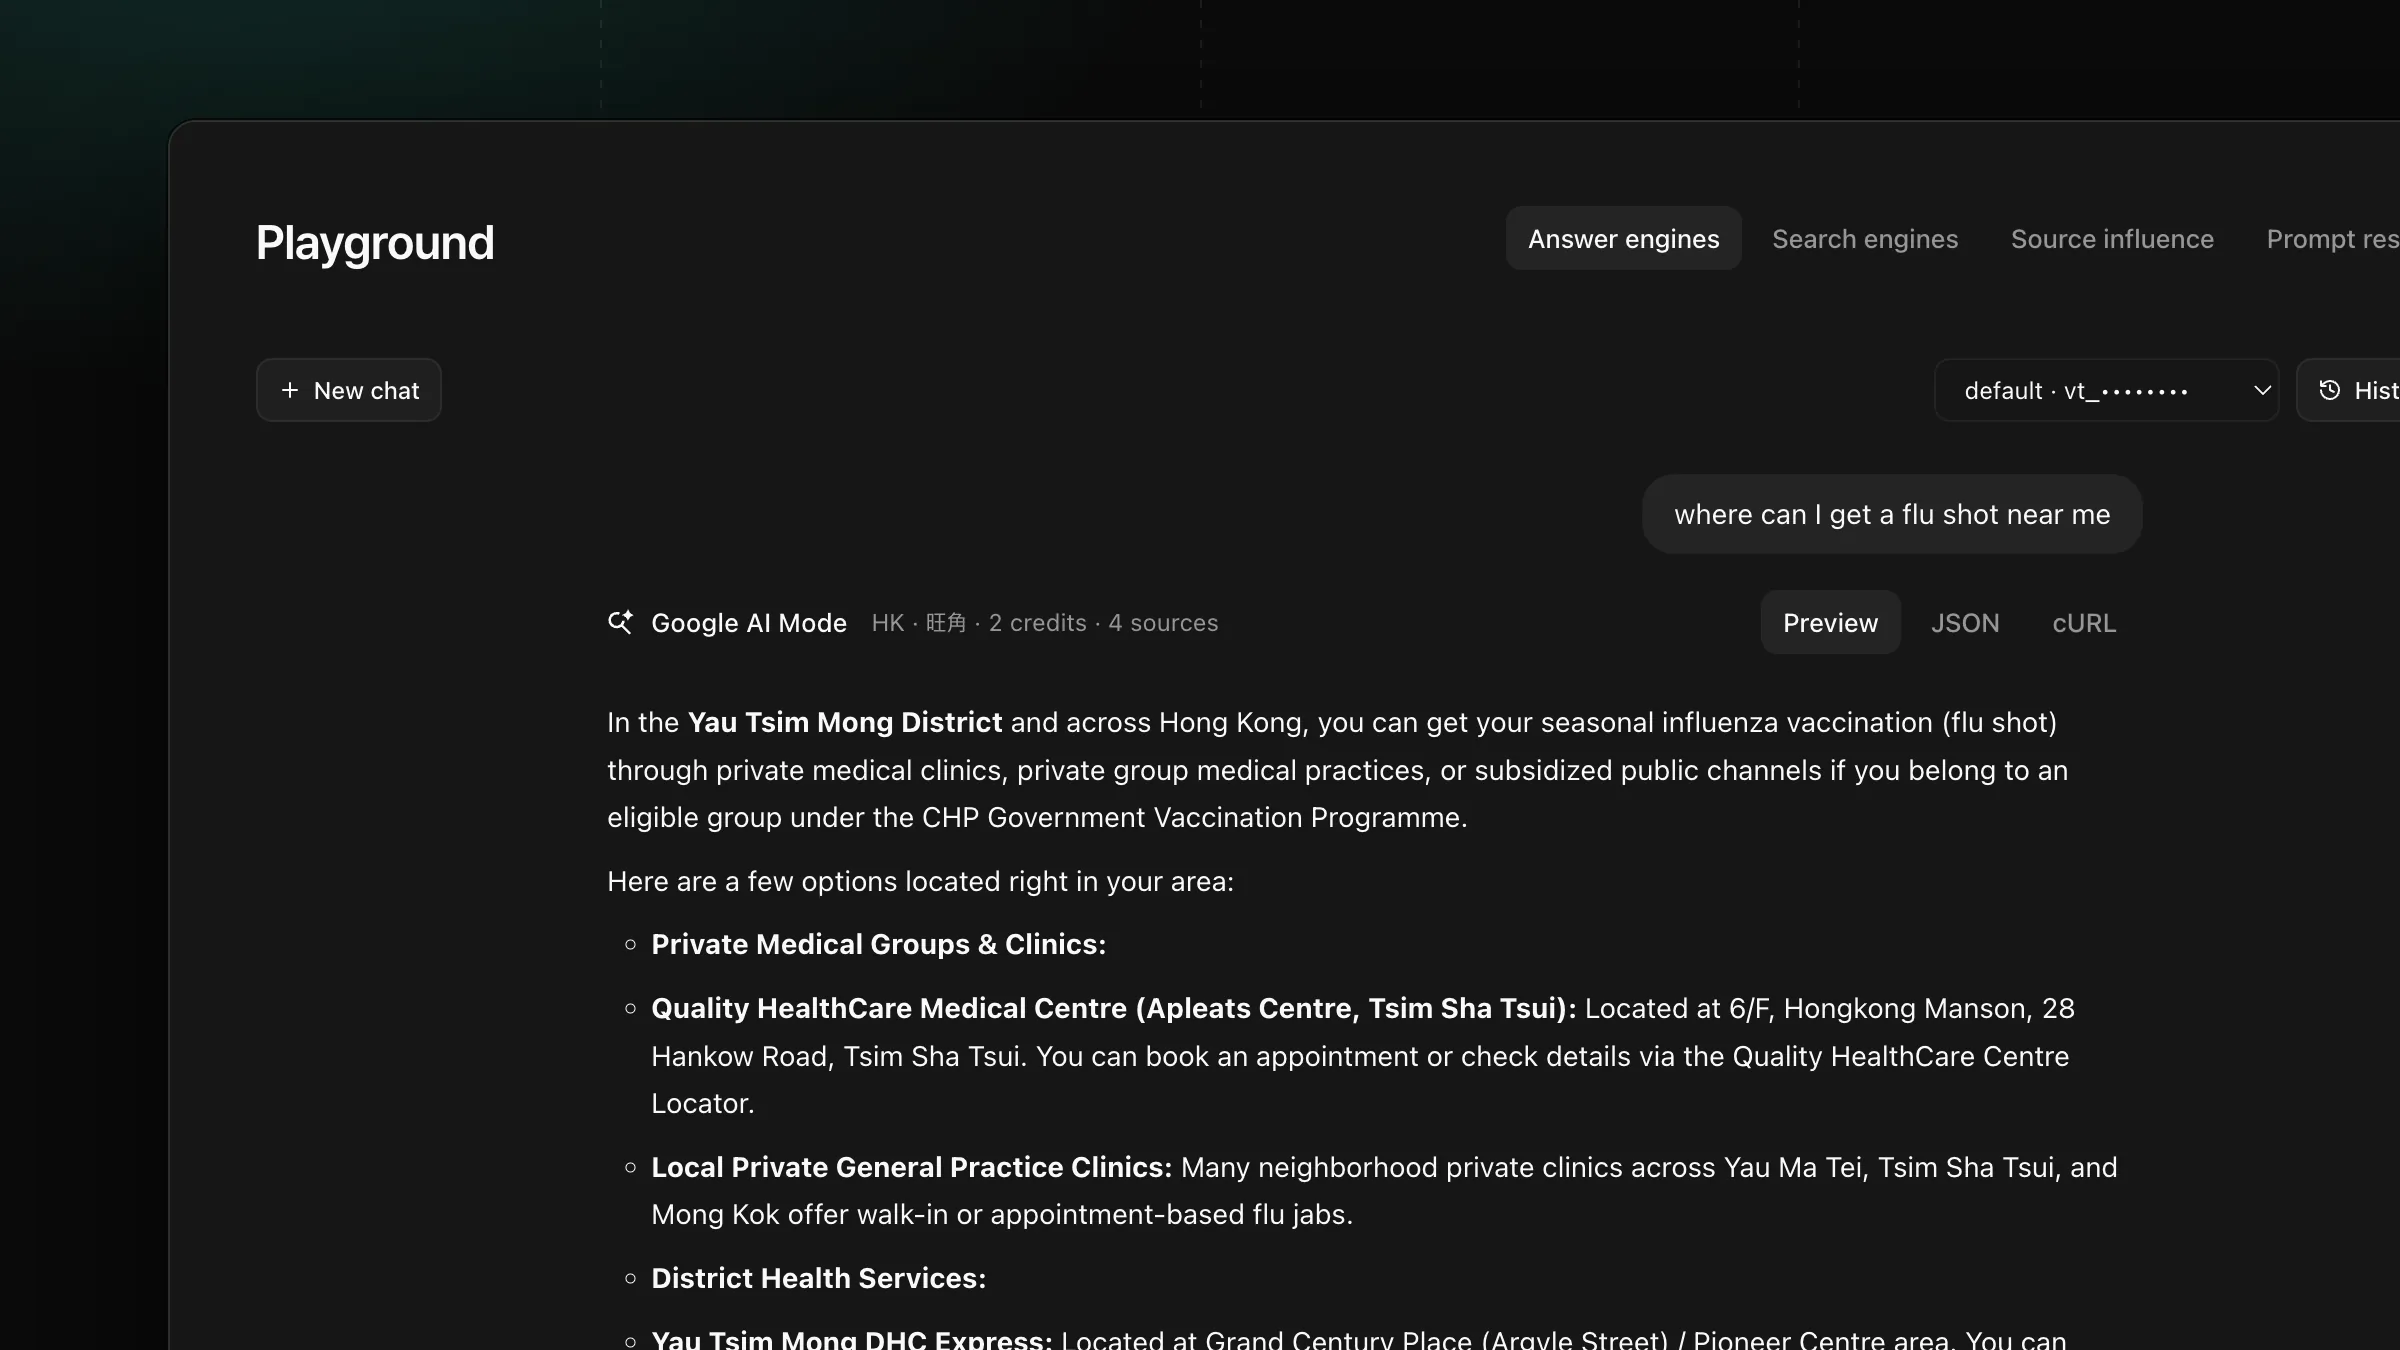
Use payload.location em tarefas GOOGLE, AIMODE e GOOGLE_SERP para receber a AI Overview, a resposta do AI Mode e os resultados que um usuário vê naquele local.
Receba atualizações do produto por e-mail.