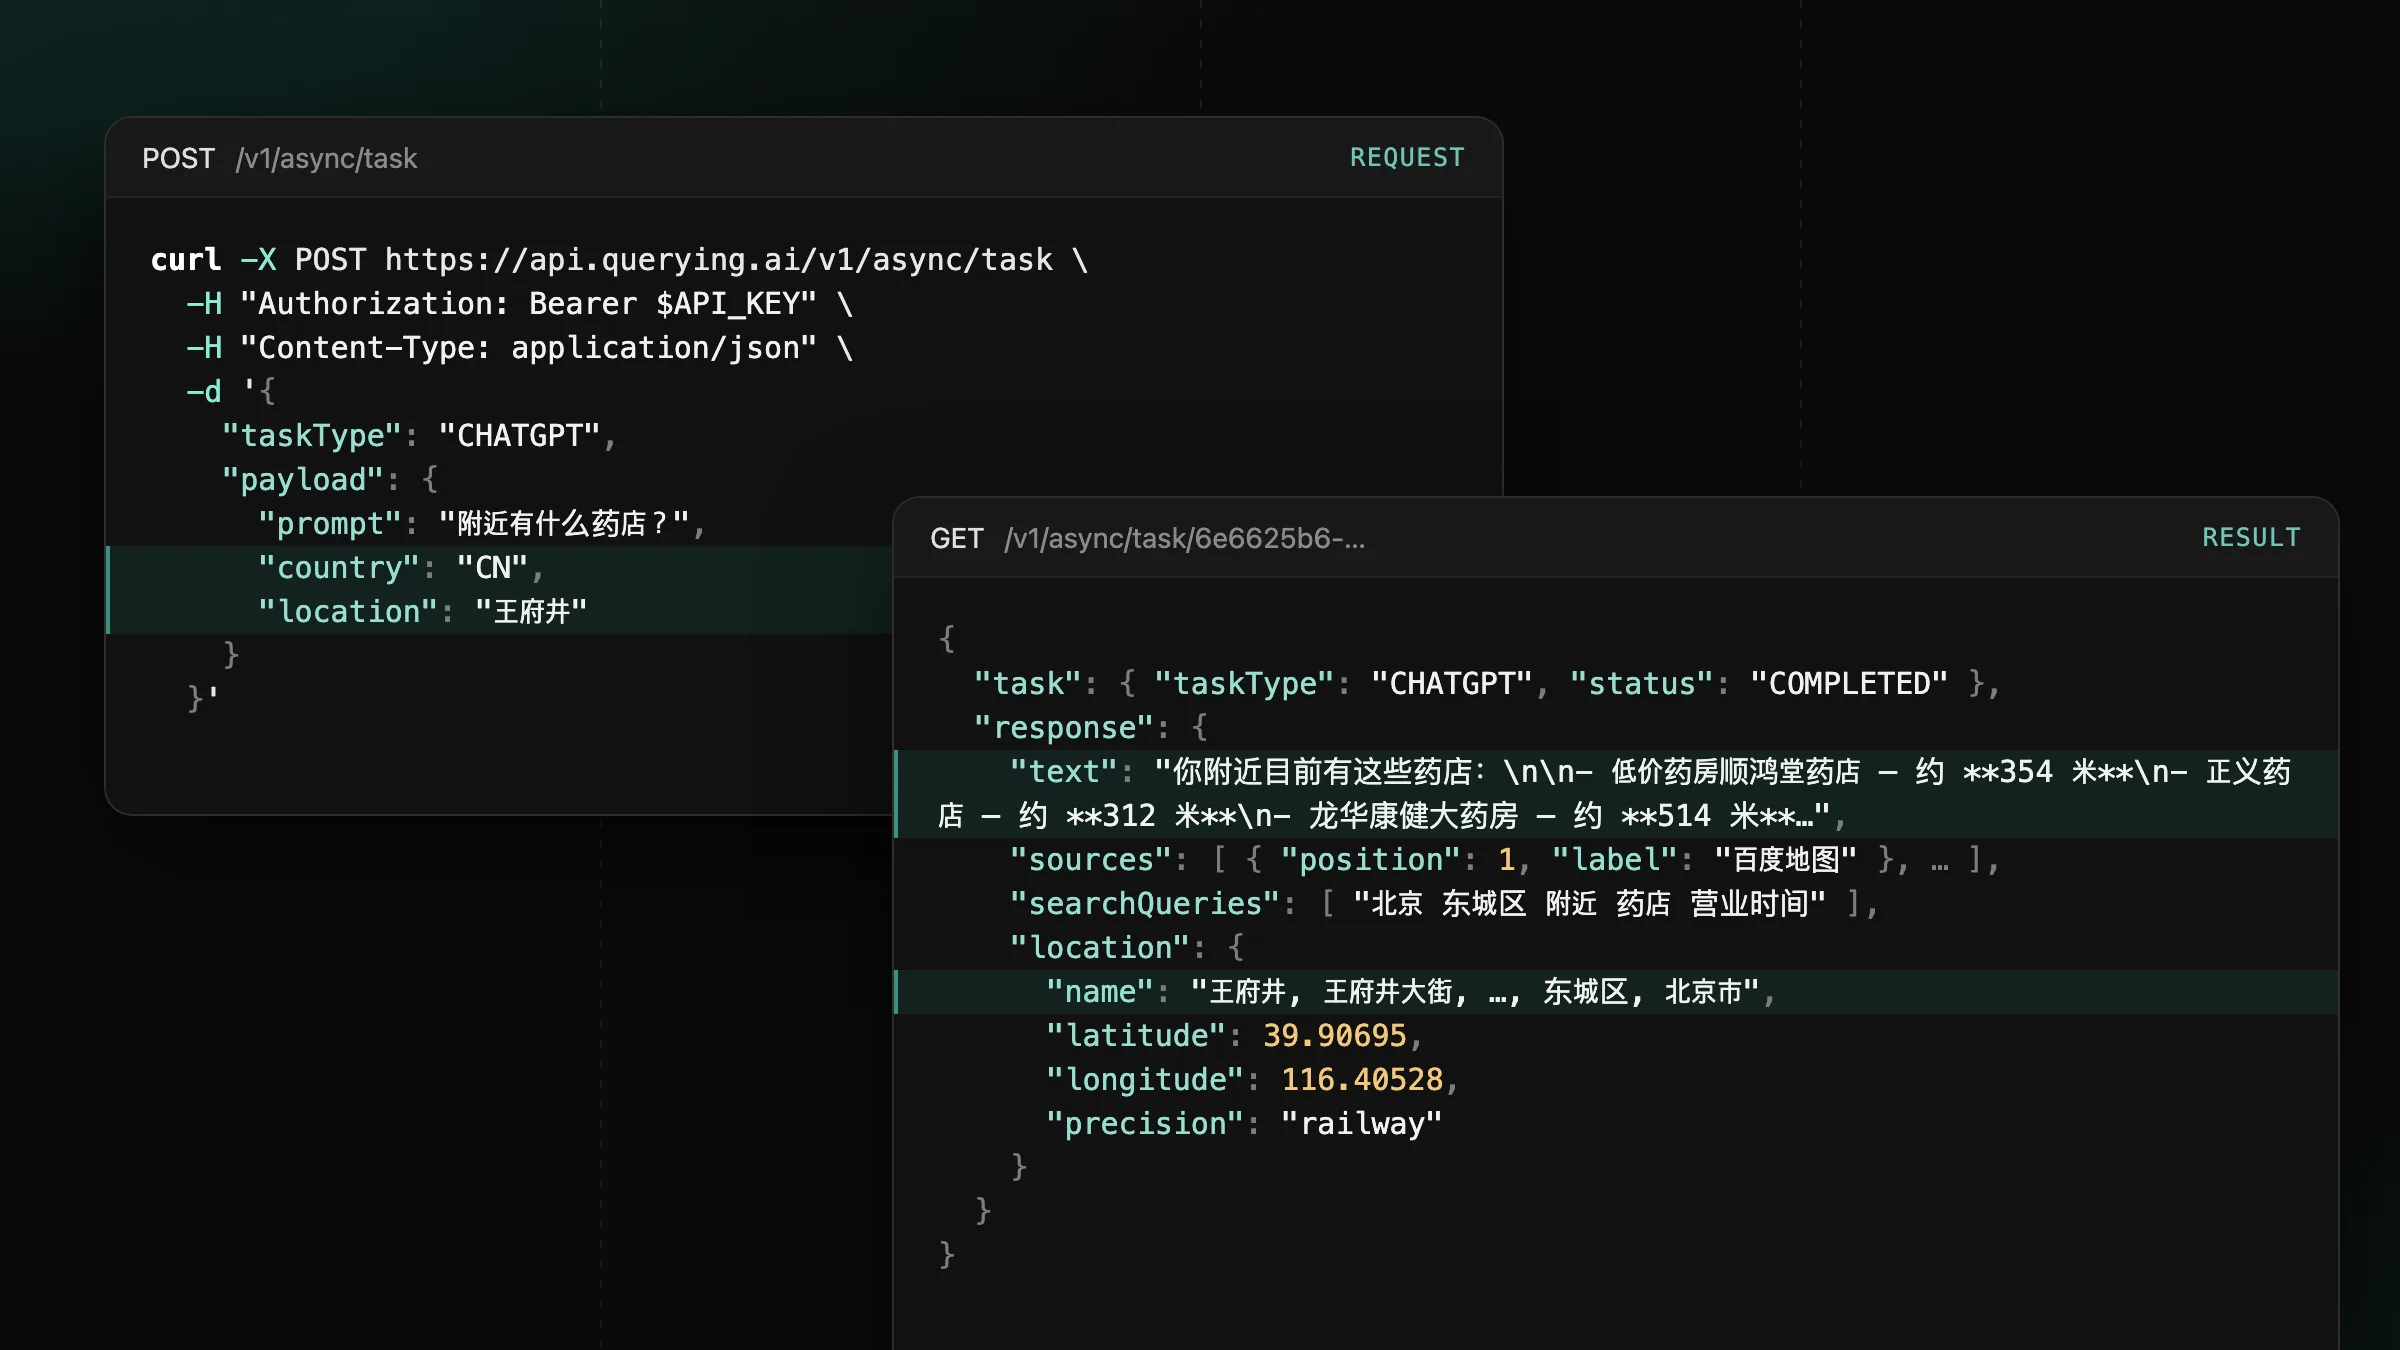
ChatGPT、Gemini、Googleで中国本土に対応しました
CHATGPT、GEMINI、GOOGLEのタスクでcountryをCNまたはHKにすると、中国本土と香港のユーザーが見る回答を取得できます。
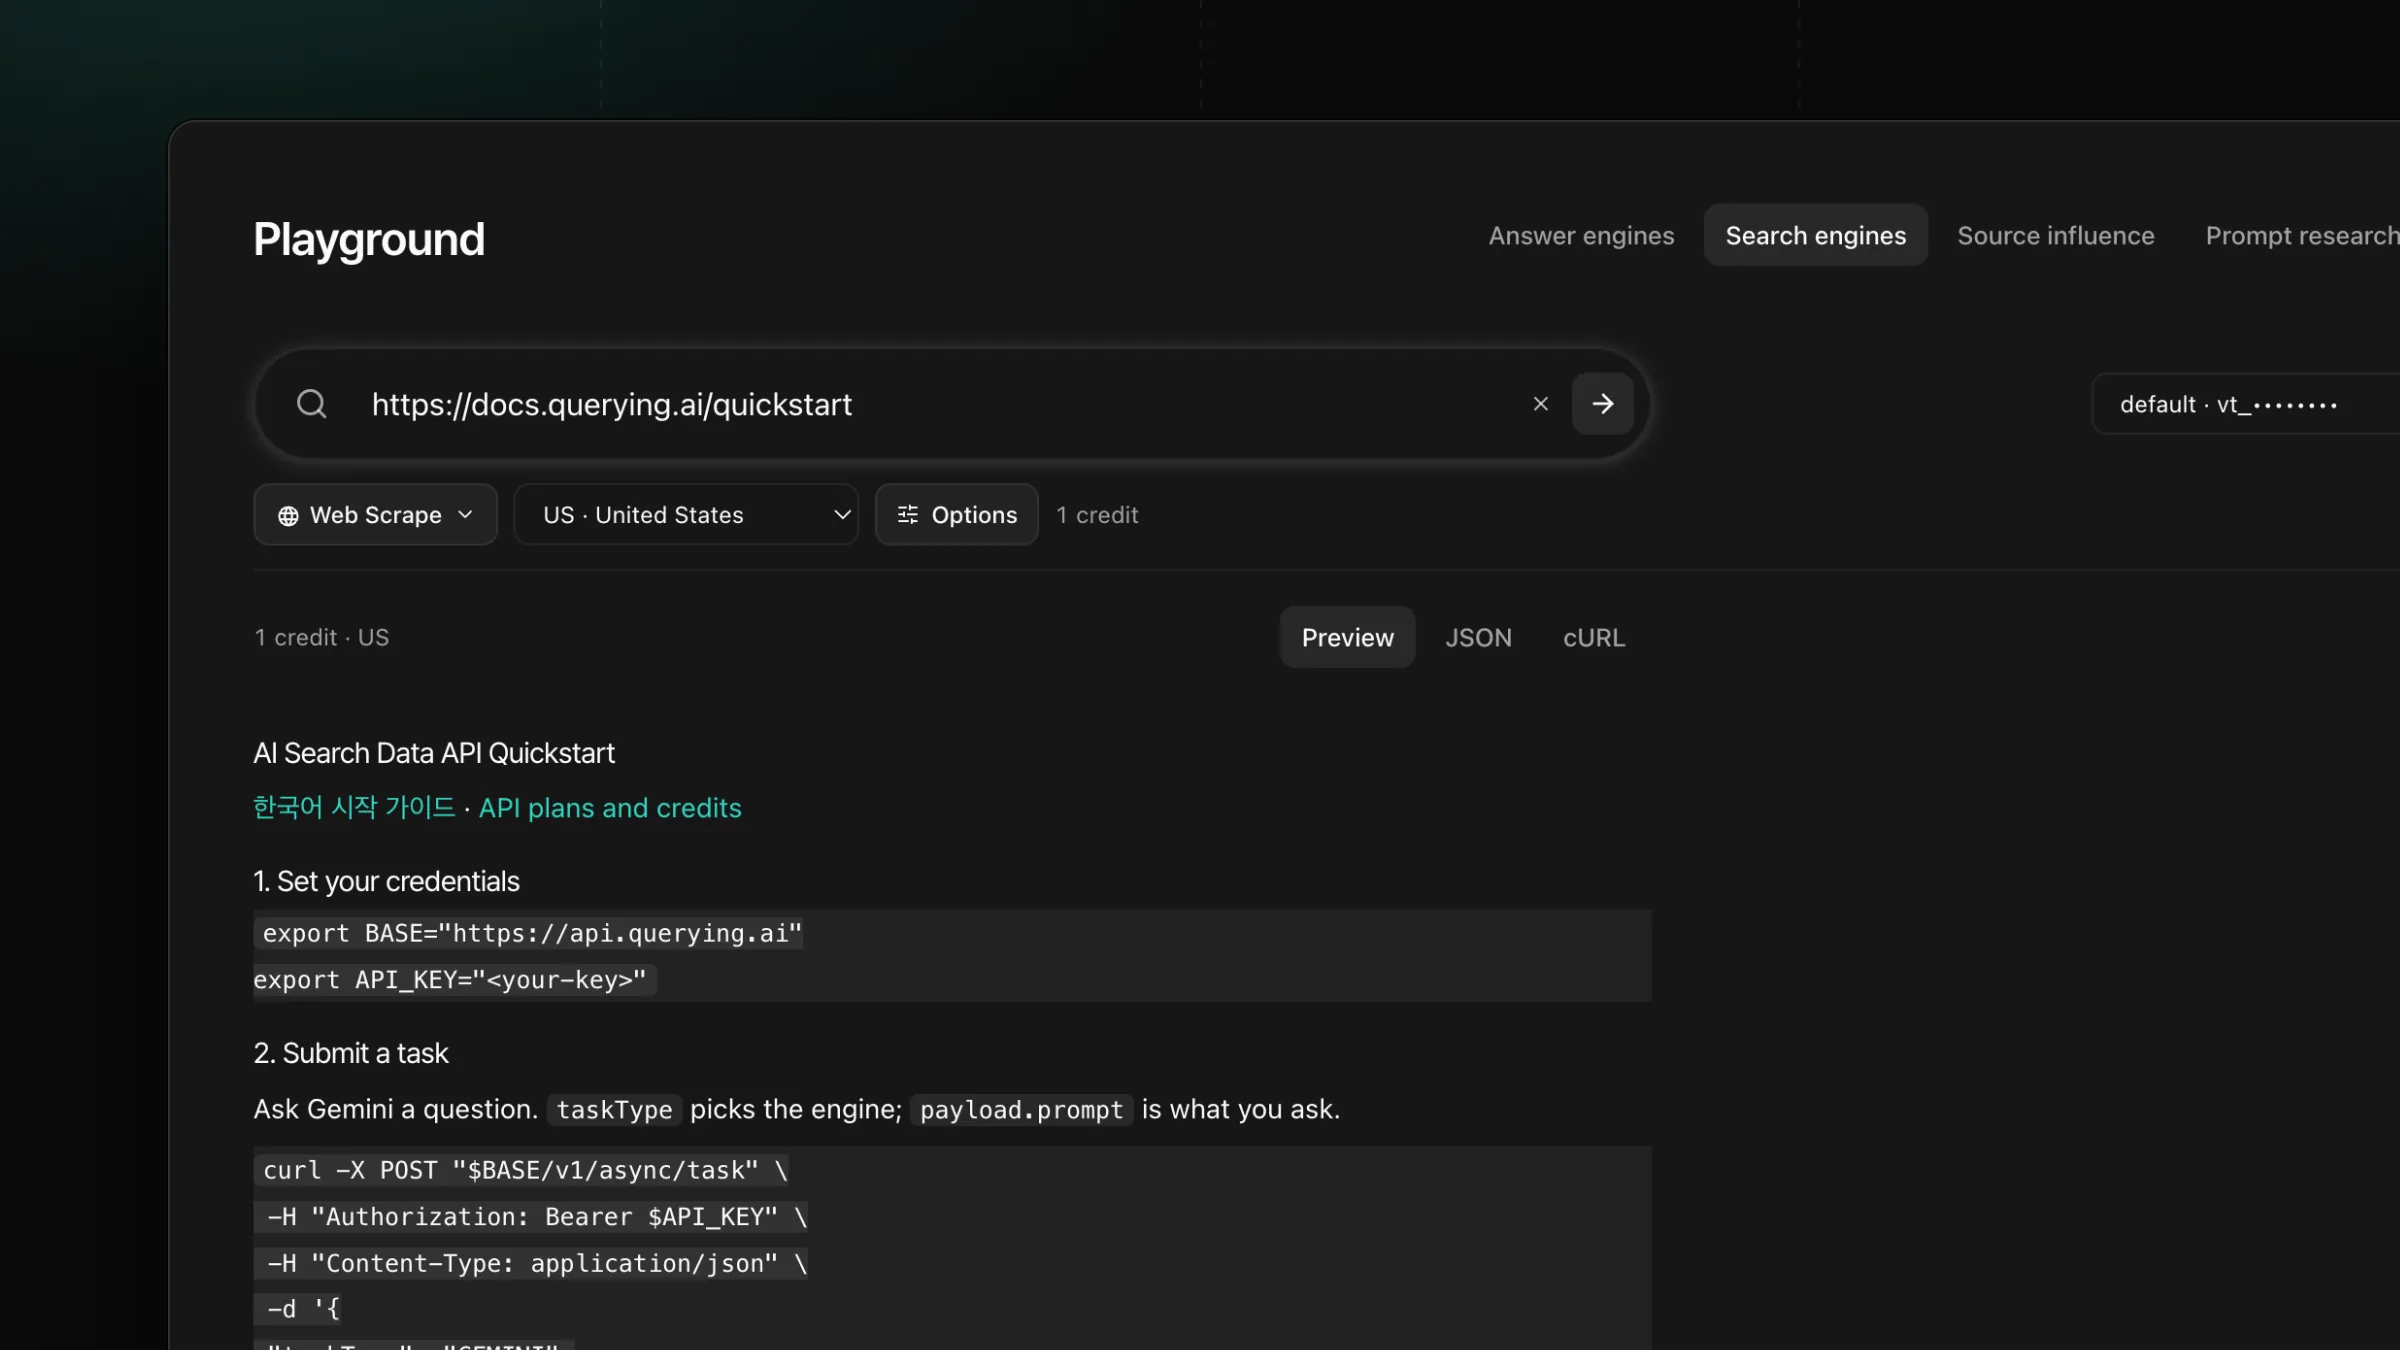
Web ScrapeはURLの本文をMarkdownとして取得します。完了したリクエストごとに1クレジットです。
markdown: ページの本文を、見出し、段落、リスト、表、リンク、画像とともに受け取ります。サイトのヘッダー、フッター、ナビゲーションは取り除きます。title、description、author、publishedAt、siteName、language、image: ページが示している情報をそのまま受け取ります。finalUrlとstatusCode: リダイレクト後の最終URLと、サイトが返したステータスです。images: markdown内の画像を、登場する順に代替テキスト付きで受け取ります。公開されているhttpまたはhttpsのURLを、2,048文字まで送ります。Web Scrapeはページを開き、ショップの商品ページのようにスクリプトで描画されるページは描画してから読み取り、読者が目的とする本文、表、画像を残します。結果は整ったMarkdownなので、そのまま保存、検索、分析に使えます。
maxCharsで長さを1,000〜200,000文字の範囲で指定します(既定は100,000文字)。長いページは段落の切れ目で区切り、truncated: trueを付けます。country(既定はUS)は、ページをリクエストする言語と地域を決めます。PDF、404や410を返すページ、リクエストを拒否したサイトはPAGE_UNAVAILABLEで終了し、メッセージにサイトの応答が入ります。
GOOGLE_SERPの結果のlinkを渡し、検索語ごとの上位ページを読みます。scrape_pageで、AIアシスタントから直接ページを読みます。API キーを Authorization ヘッダーに入れてリクエストを送ります。
curl -X POST https://api.querying.ai/v1/async/task \
  -H "Authorization: Bearer $QUERYING_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "taskType": "WEB_SCRAPE",
    "payload": {
      "url": "https://docs.querying.ai/quickstart",
      "country": "US"
    }
}'taskTypestring必須CHATGPT や GOOGLE などを指定します。payload.urlstring必須payload.maxCharsintegermarkdown の長さの上限。1,000〜200,000、既定値は100,000。長いページは段落の切れ目で終わり、truncated が付きます。payload.countrystringUS。webhook.urlstringidempotencyKeystring完了したタスクはこの形で届きます。長さを抑えて抜粋しています。
{
  "success": true,
  "task": {
    "id": "910017b1-4fd5-4bc7-8895-bbe6b1b0d1df",
    "taskType": "WEB_SCRAPE",
    "status": "COMPLETED",
    "createdAt": "2026-10-02T15:48:34.088Z"
  },
  "credits": { "creditsToCharge": 1, "creditsCharged": 1 },
  "response": {
    "url": "https://docs.querying.ai/quickstart",
    "finalUrl": "https://docs.querying.ai/quickstart",
    "statusCode": 200,
    "title": "AI Search Data API Quickstart",
    "description": "Submit a task, receive a result — with webhooks or by polling.",
    "siteName": "querying.ai",
    "language": "en",
    "markdown": "# AI Search Data API Quickstart\n\n[한국어 시작 가이드](https://querying.ai/ko/guides/quickstart) · [API plans and credits](https://querying.ai/en/pricing)\n\n## 1\\. Set your credentials\n\n```shellscript\nexport BASE=\"https://api.querying.ai\"\nexport API_KEY=\"<your-key>\"\n```\n\n…",
    "images": [],
    "truncated": false
  }
}task.statusstringQUEUED、PROCESSING を経て、回答付きの COMPLETED か error 付きの FAILED で終わります。credits.creditsChargedintegerresponse.markdownstringresponse.titlestringdescription、author、siteName、language も届きます。response.publishedAtstringresponse.finalUrlstringstatusCode。response.imagesarraymarkdown 内の画像を本文の順に。それぞれ url と alt。response.truncatedbooleanmarkdown が maxChars に達し、段落の切れ目で終わった場合は true。リクエストすると status が QUEUED のタスクがすぐに返ります。status が COMPLETED か FAILED になるまで GET /v1/async/task/{id} で取得するか、webhook.url を指定して同じ task、credits、response をサーバーで受け取ります。結果はタスクの完了から24時間取得できます。
curl https://api.querying.ai/v1/async/task/$TASK_ID \
-H "Authorization: Bearer $QUERYING_API_KEY"完了したページ1件につき1クレジットを使用します。
CHATGPT、GEMINI、GOOGLEのタスクでcountryをCNまたはHKにすると、中国本土と香港のユーザーが見る回答を取得できます。
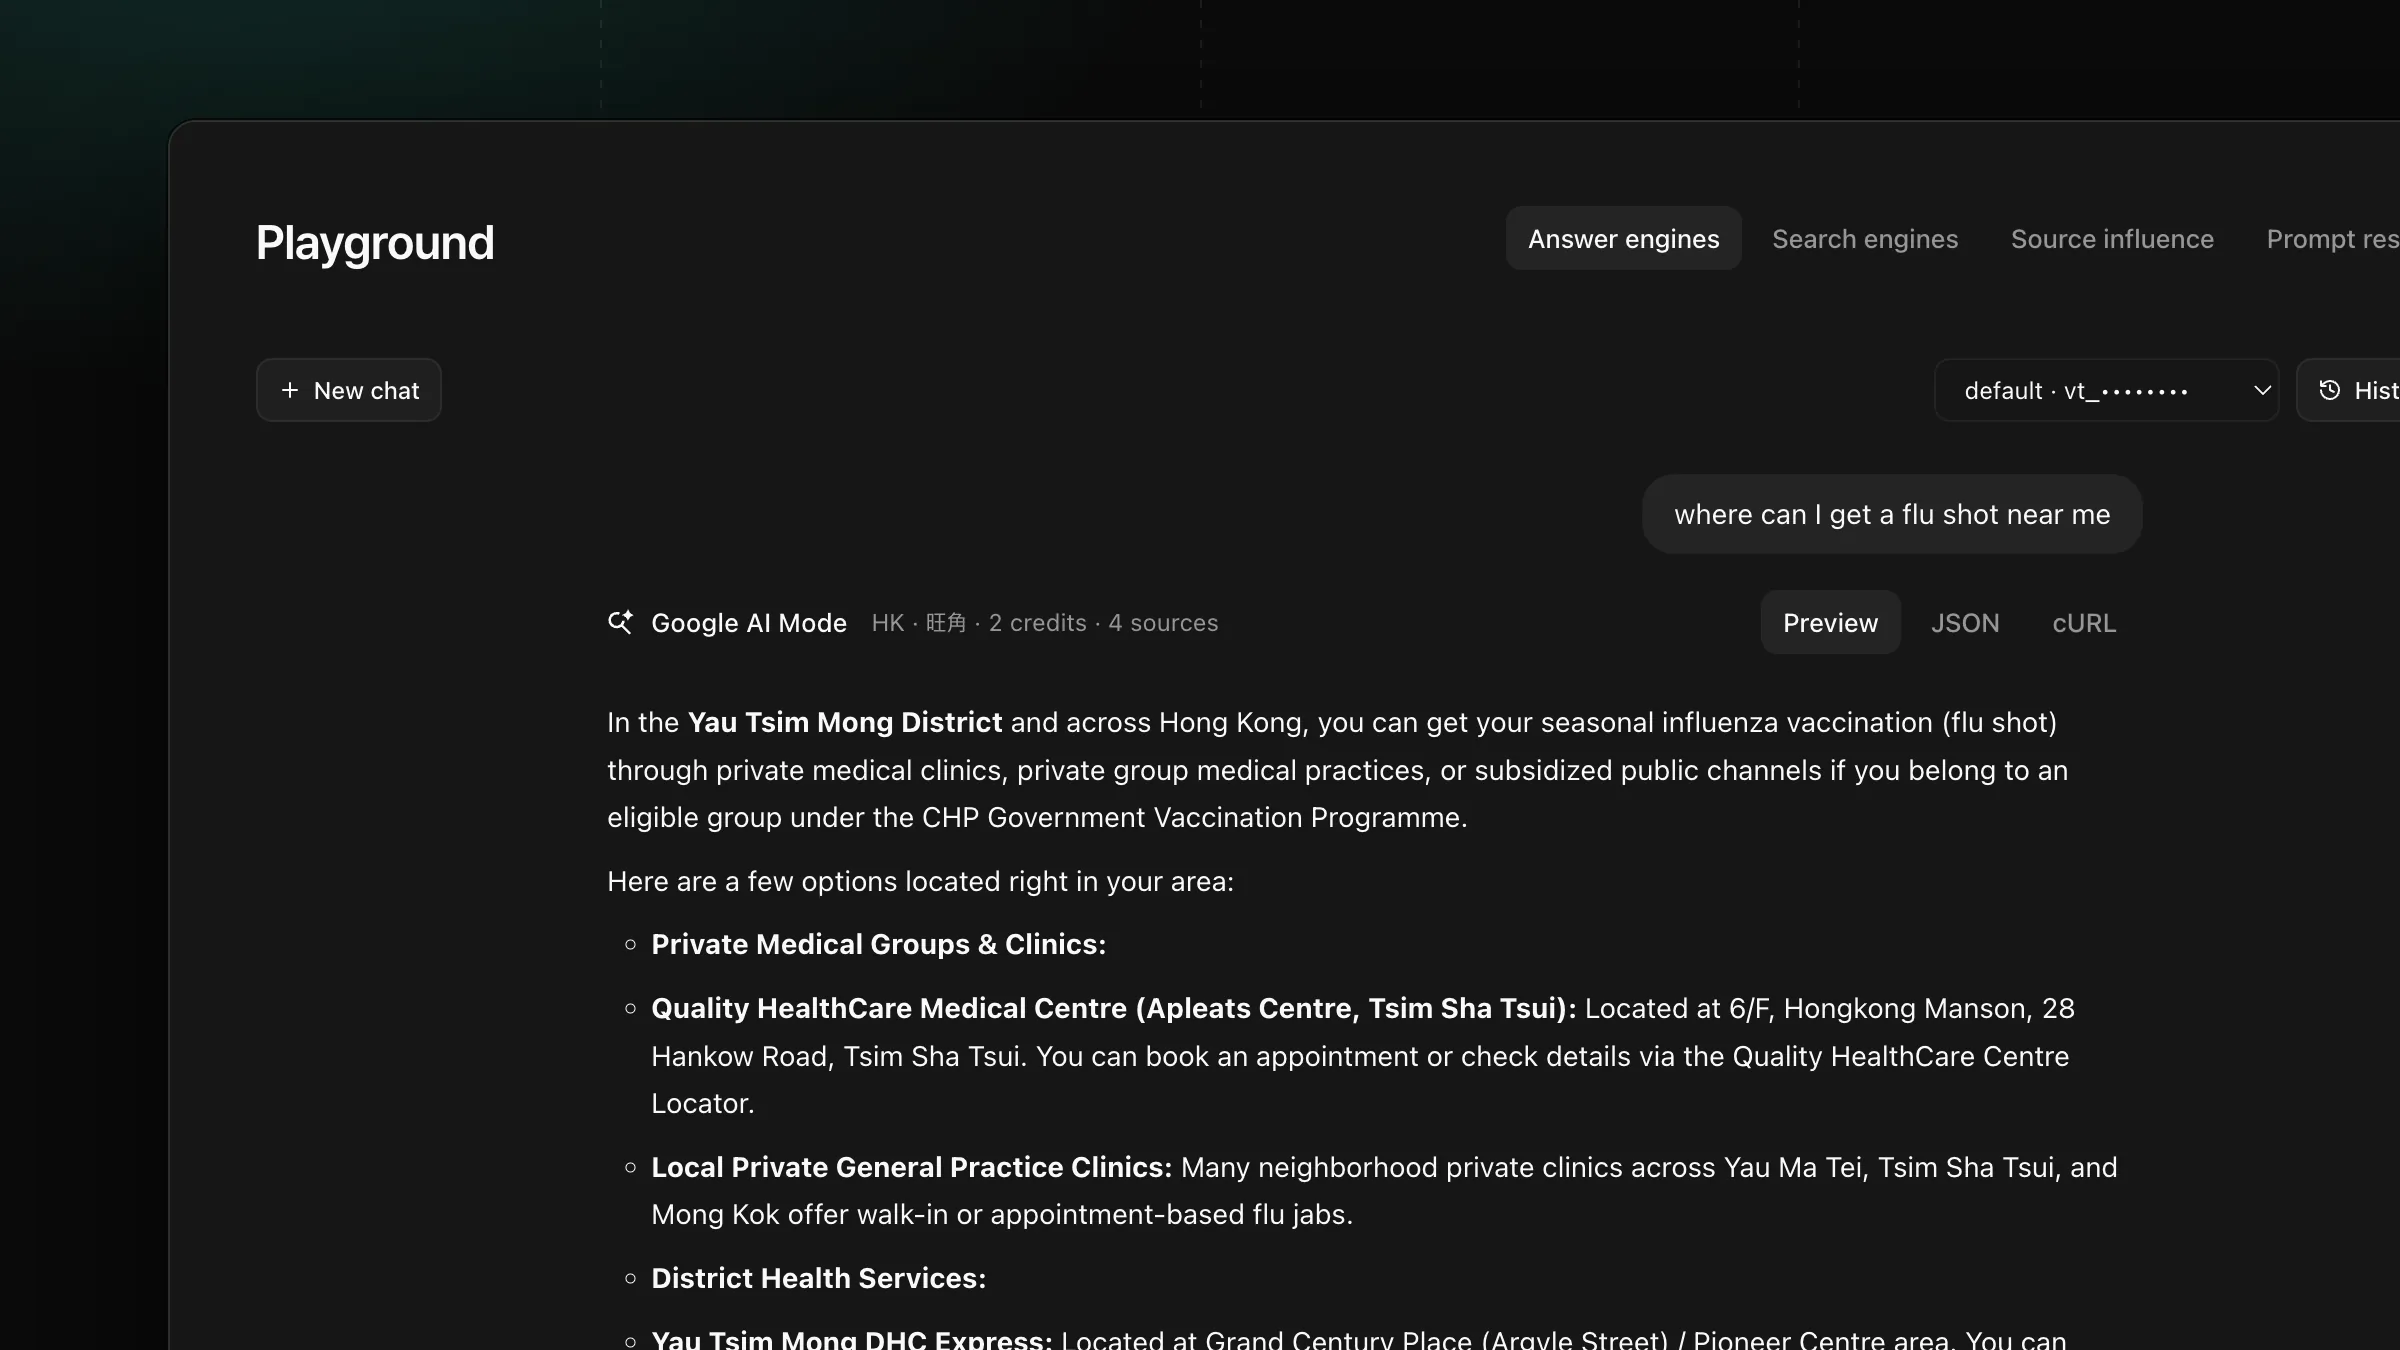
GOOGLE、AIMODE、GOOGLE_SERPのタスクにpayload.locationを指定すると、その場所にいるユーザーが見るAI Overview、AI Modeの回答、検索結果を取得できます。
製品の更新をメールでお届けします。