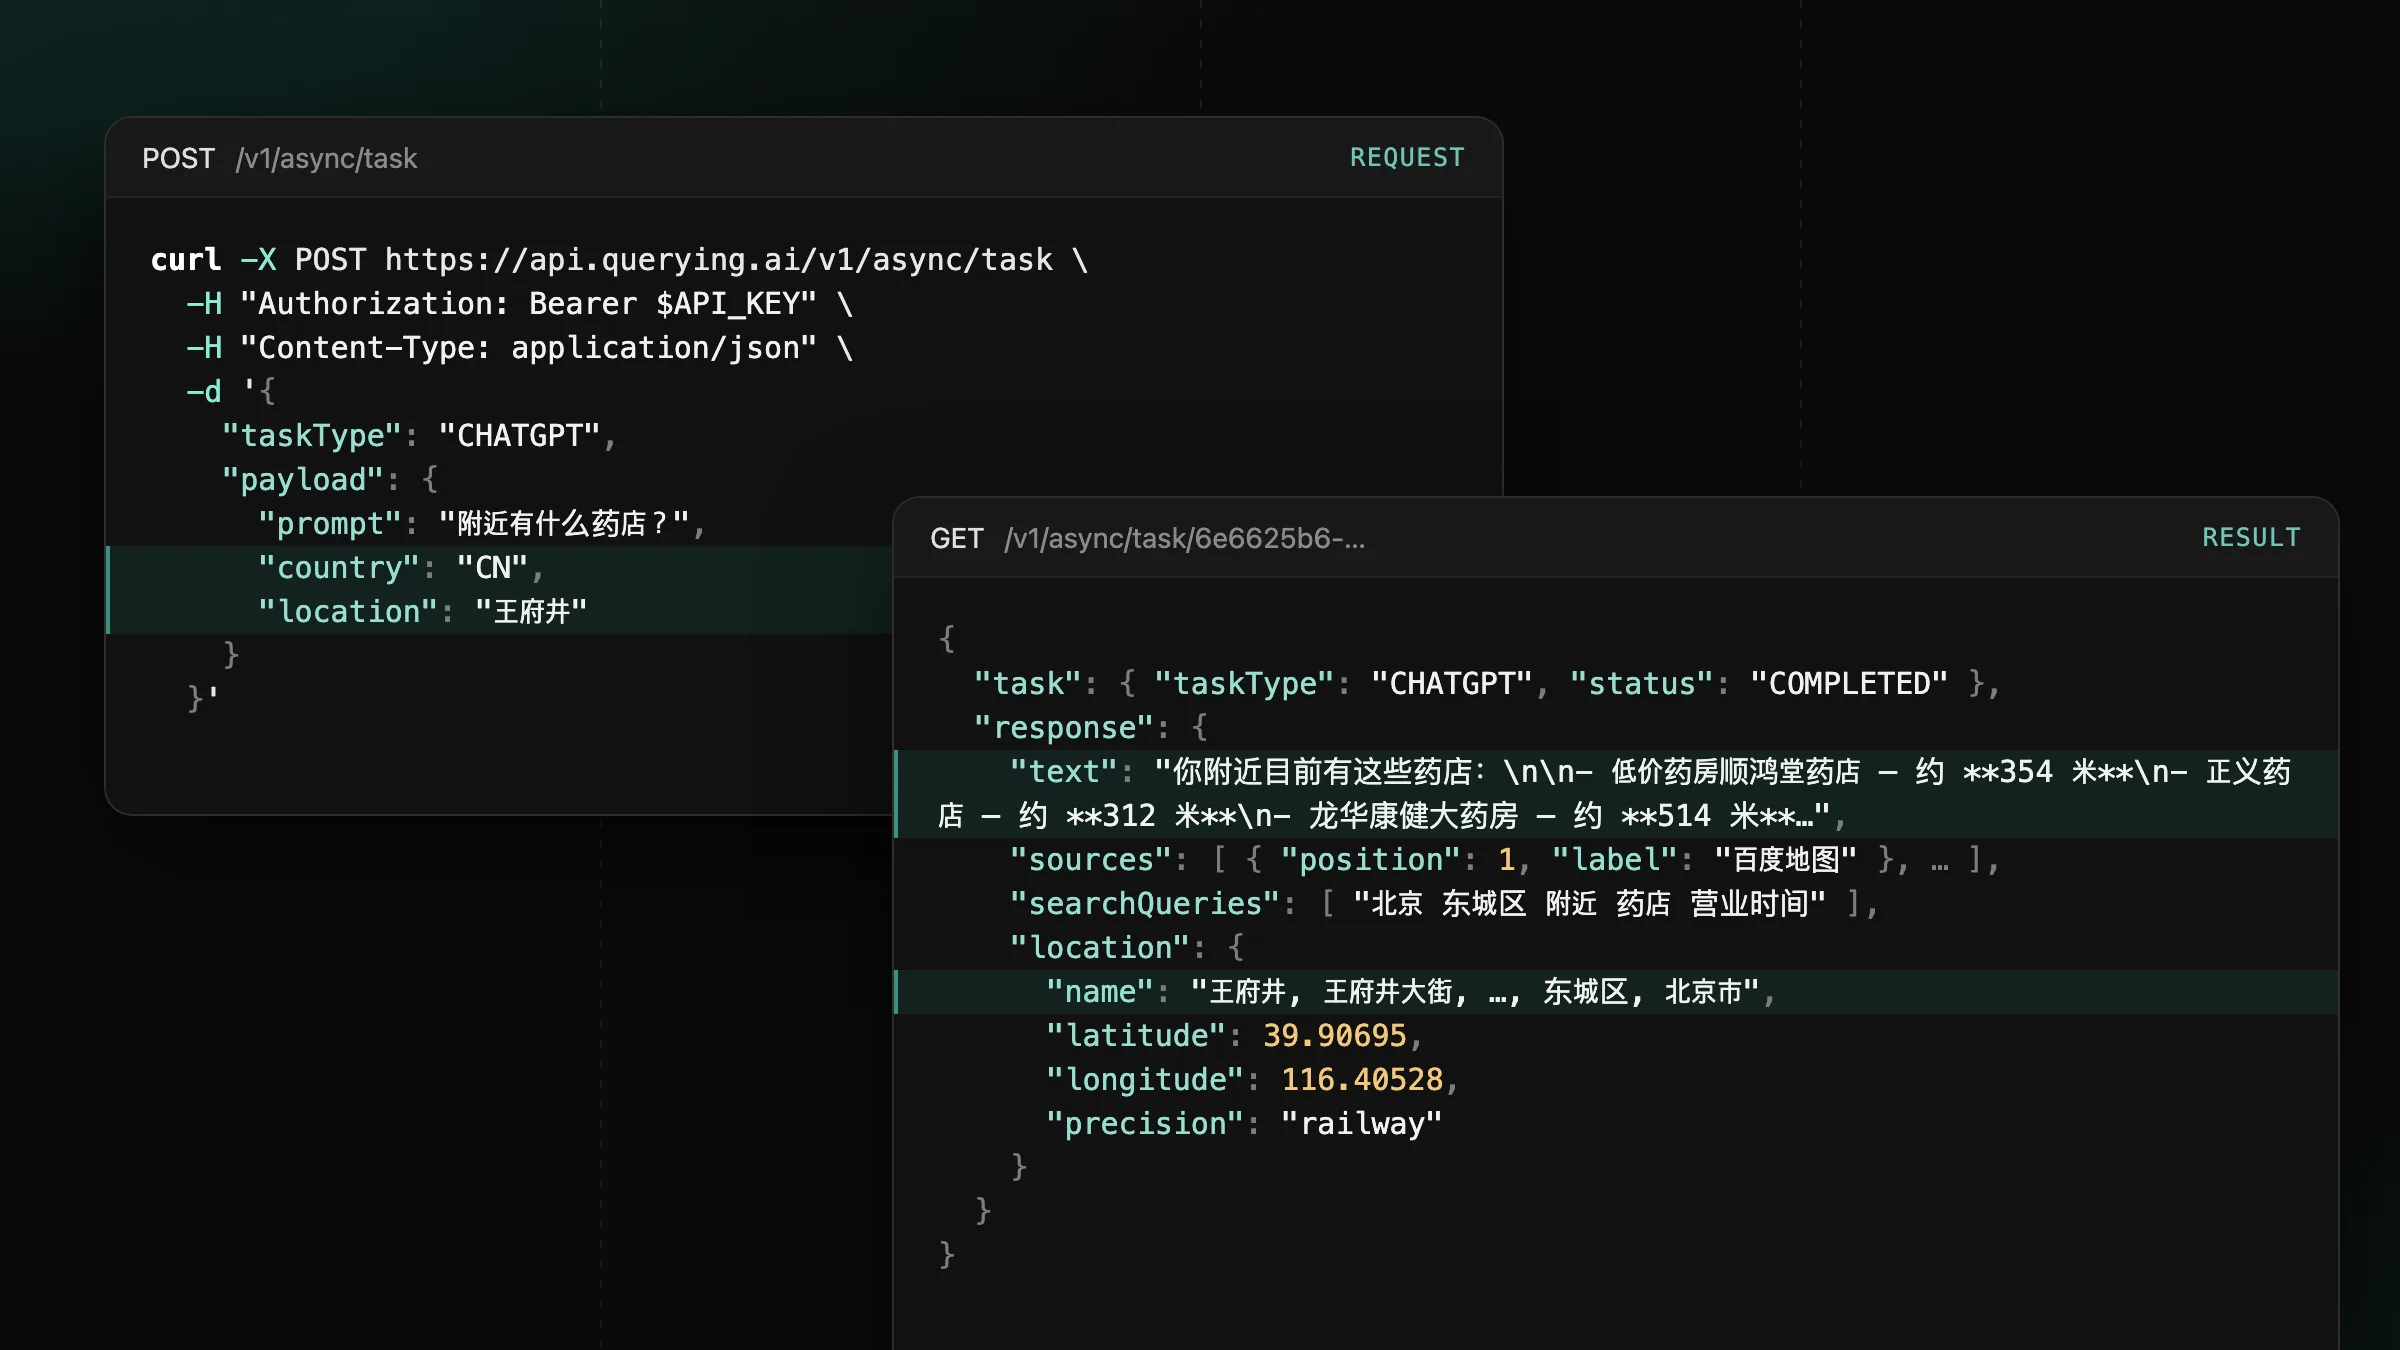
China continental ya está disponible en ChatGPT, Gemini y Google
Usa country CN o HK en tareas CHATGPT, GEMINI y GOOGLE para ver las respuestas que reciben los usuarios de China continental y Hong Kong.
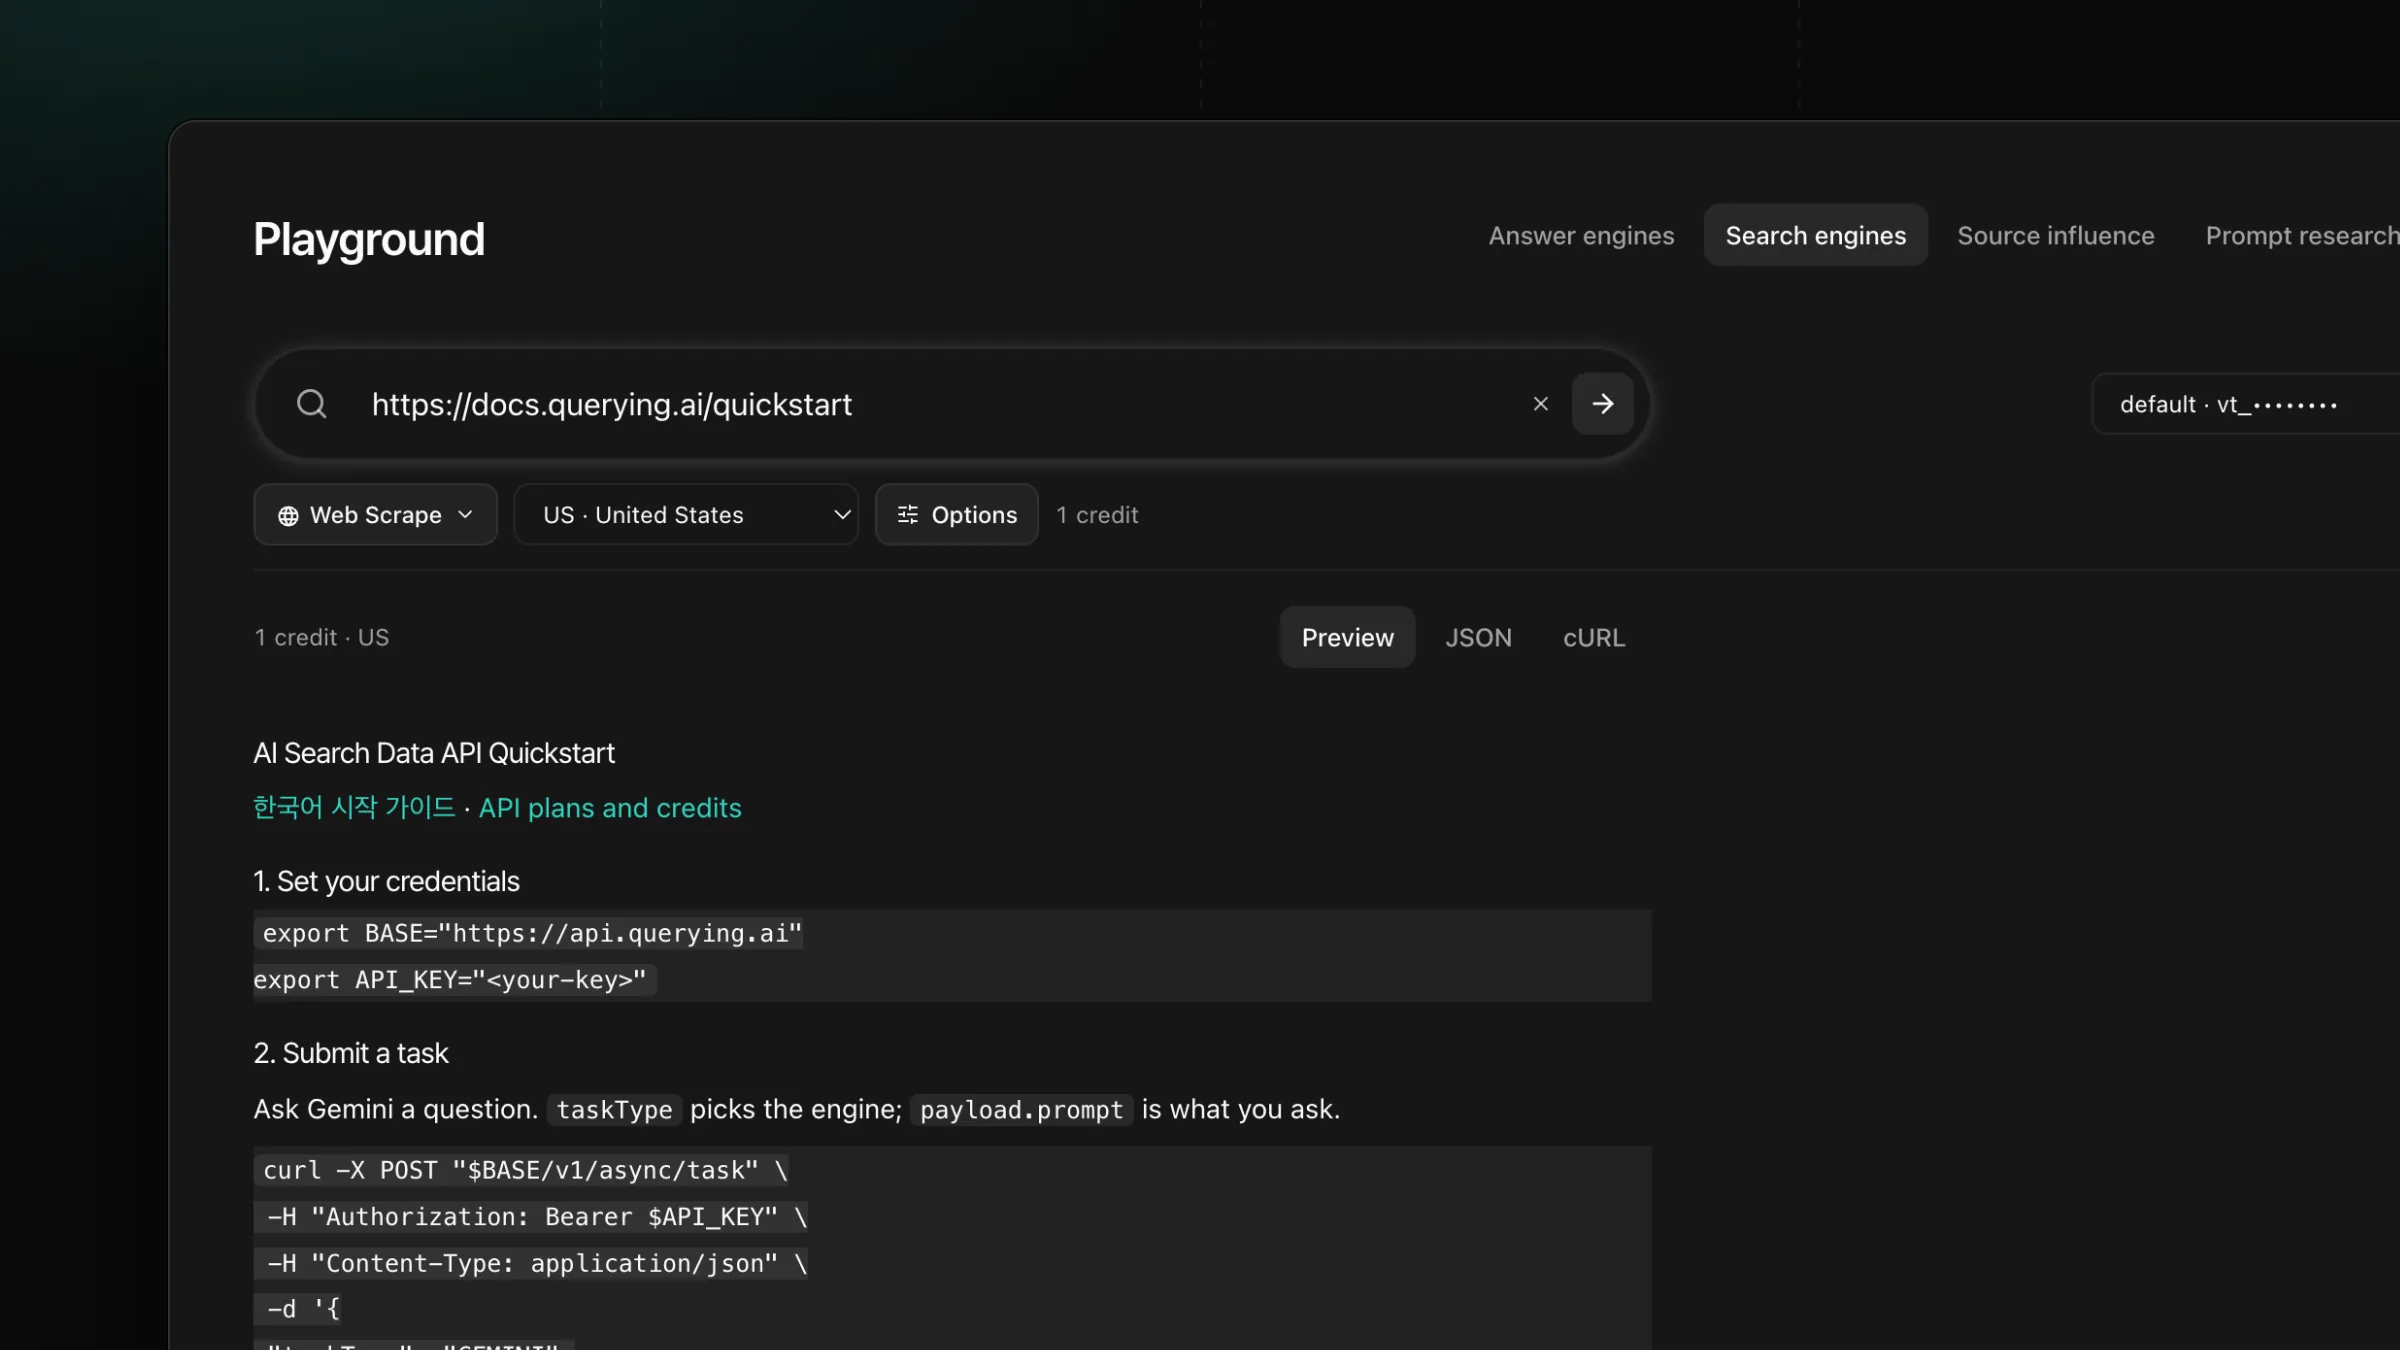
Web Scrape extrae el contenido principal de una URL en Markdown por 1 crédito por solicitud completada.
markdown: el contenido principal de la página con sus títulos, párrafos, listas, tablas, enlaces e imágenes, y con la cabecera, el pie y la navegación del sitio eliminados.title, description, author, publishedAt, siteName, language e image cuando la página los declara.finalUrl y statusCode: la dirección final tras las redirecciones y el estado que devolvió el sitio.images: cada imagen de markdown, en el orden en que aparece y con su texto alternativo.Envía una URL pública http o https de hasta 2.048 caracteres. Web Scrape abre la página, renderiza las que dibuja un script, como las fichas de producto de una tienda, y conserva el contenido que busca el lector: el texto, las tablas y las imágenes. El resultado es Markdown limpio, listo para guardar, buscar o analizar.
maxChars fija la longitud, de 1.000 a 200.000 caracteres (100.000 por defecto). Una página larga se corta en un salto de párrafo y marca truncated: true. country (US por defecto) fija el idioma y la región con que se pide la página. Un PDF, una página que responde 404 o 410, o un sitio que rechaza la solicitud terminan la tarea con PAGE_UNAVAILABLE y la respuesta del sitio en el mensaje.
link de los resultados de GOOGLE_SERP para leer las páginas que posicionan en una búsqueda.scrape_page.Envía la solicitud con tu clave de API en la cabecera Authorization.
curl -X POST https://api.querying.ai/v1/async/task \
  -H "Authorization: Bearer $QUERYING_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "taskType": "WEB_SCRAPE",
    "payload": {
      "url": "https://docs.querying.ai/quickstart",
      "country": "US"
    }
}'taskTypestringObligatorioCHATGPT o GOOGLE.payload.urlstringObligatoriopayload.maxCharsintegermarkdown, de 1.000 a 200.000. Por defecto 100.000. Una página más larga termina en un salto de párrafo y lleva truncated.payload.countrystringUS.webhook.urlstringidempotencyKeystringAsí llega una tarea terminada, recortada para que se lea mejor.
{
  "success": true,
  "task": {
    "id": "910017b1-4fd5-4bc7-8895-bbe6b1b0d1df",
    "taskType": "WEB_SCRAPE",
    "status": "COMPLETED",
    "createdAt": "2026-10-02T15:48:34.088Z"
  },
  "credits": { "creditsToCharge": 1, "creditsCharged": 1 },
  "response": {
    "url": "https://docs.querying.ai/quickstart",
    "finalUrl": "https://docs.querying.ai/quickstart",
    "statusCode": 200,
    "title": "AI Search Data API Quickstart",
    "description": "Submit a task, receive a result — with webhooks or by polling.",
    "siteName": "querying.ai",
    "language": "en",
    "markdown": "# AI Search Data API Quickstart\n\n[한국어 시작 가이드](https://querying.ai/ko/guides/quickstart) · [API plans and credits](https://querying.ai/en/pricing)\n\n## 1\\. Set your credentials\n\n```shellscript\nexport BASE=\"https://api.querying.ai\"\nexport API_KEY=\"<your-key>\"\n```\n\n…",
    "images": [],
    "truncated": false
  }
}task.statusstringQUEUED, PROCESSING y al final COMPLETED con la respuesta o FAILED con error.credits.creditsChargedintegerresponse.markdownstringresponse.titlestringdescription, author, siteName y language cuando la página los declara.response.publishedAtstringresponse.finalUrlstringstatusCode.response.imagesarraymarkdown, en orden de lectura, cada una con url y alt.response.truncatedbooleantrue cuando markdown llegó a maxChars y termina en un salto de párrafo.La solicitud devuelve la tarea al instante con status QUEUED. Consulta GET /v1/async/task/{id} hasta que status sea COMPLETED o FAILED, o añade webhook.url y la tarea terminada llega a tu servidor con los mismos task, credits y response. Los resultados siguen disponibles 24 horas después de terminar la tarea.
curl https://api.querying.ai/v1/async/task/$TASK_ID \
-H "Authorization: Bearer $QUERYING_API_KEY"Cada página completada usa 1 crédito.
Usa country CN o HK en tareas CHATGPT, GEMINI y GOOGLE para ver las respuestas que reciben los usuarios de China continental y Hong Kong.
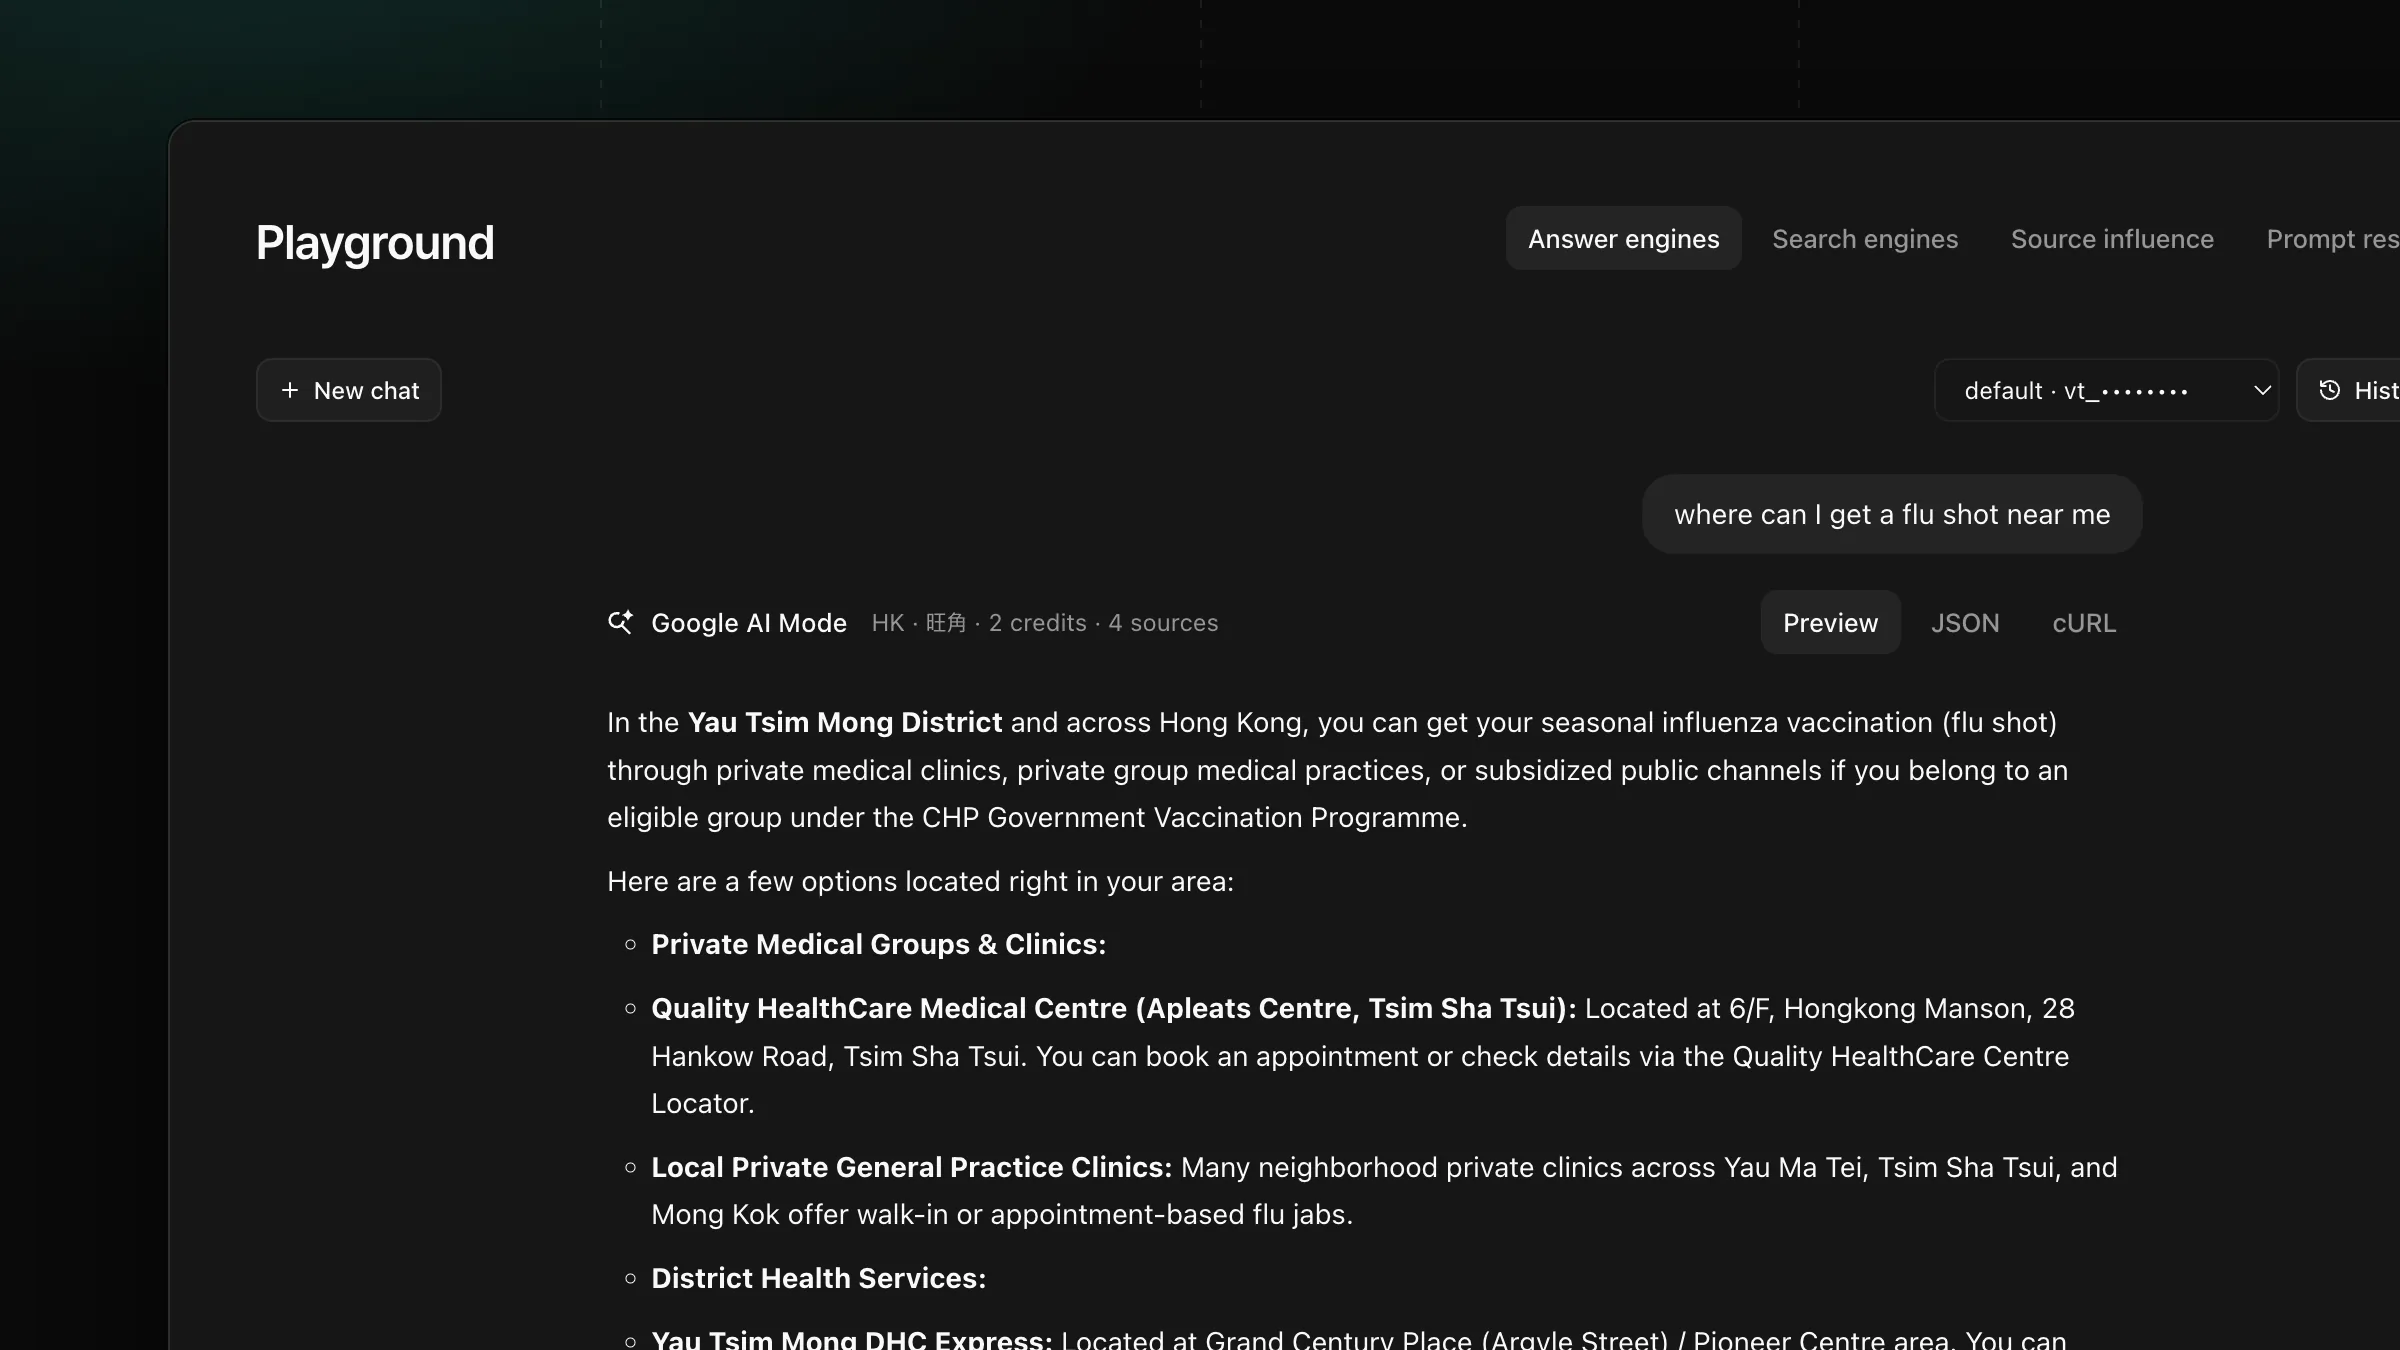
Usa payload.location en tareas GOOGLE, AIMODE y GOOGLE_SERP para ver la AI Overview, la respuesta de AI Mode y los resultados que ve un usuario en ese lugar.
Recibe las actualizaciones por correo.