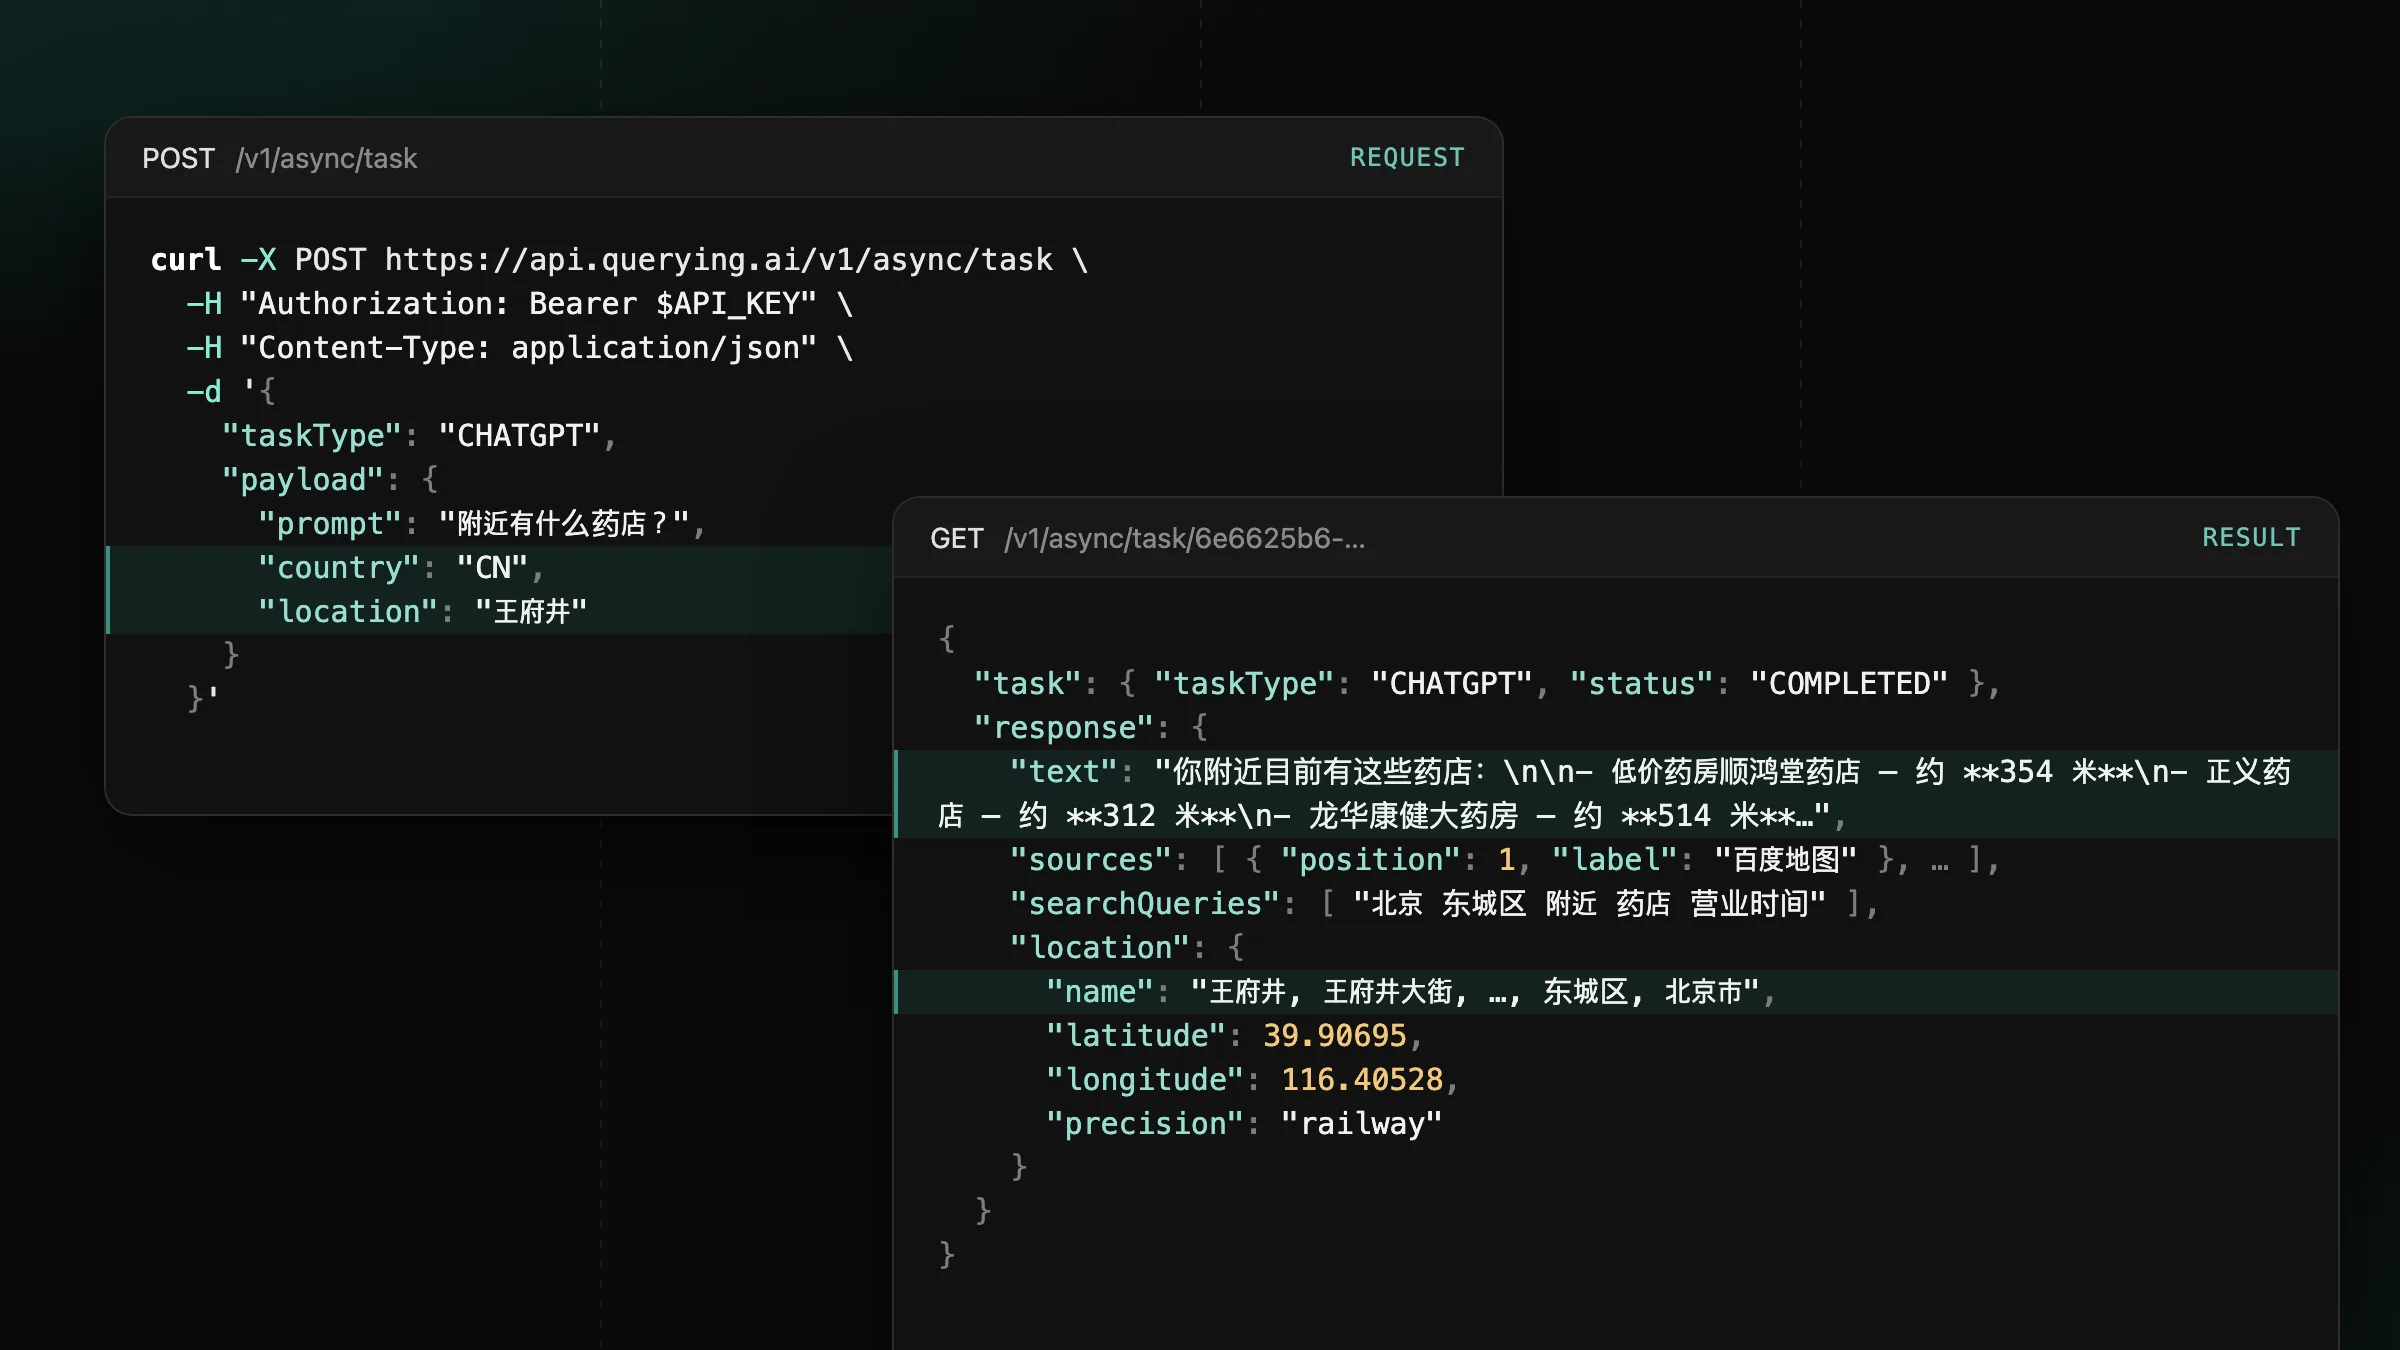
이제 ChatGPT, Gemini, Google에서 중국 본토를 지원해요
CHATGPT, GEMINI, GOOGLE 태스크의 country를 CN이나 HK로 정해 중국 본토와 홍콩 사용자가 보는 답변을 받으세요.
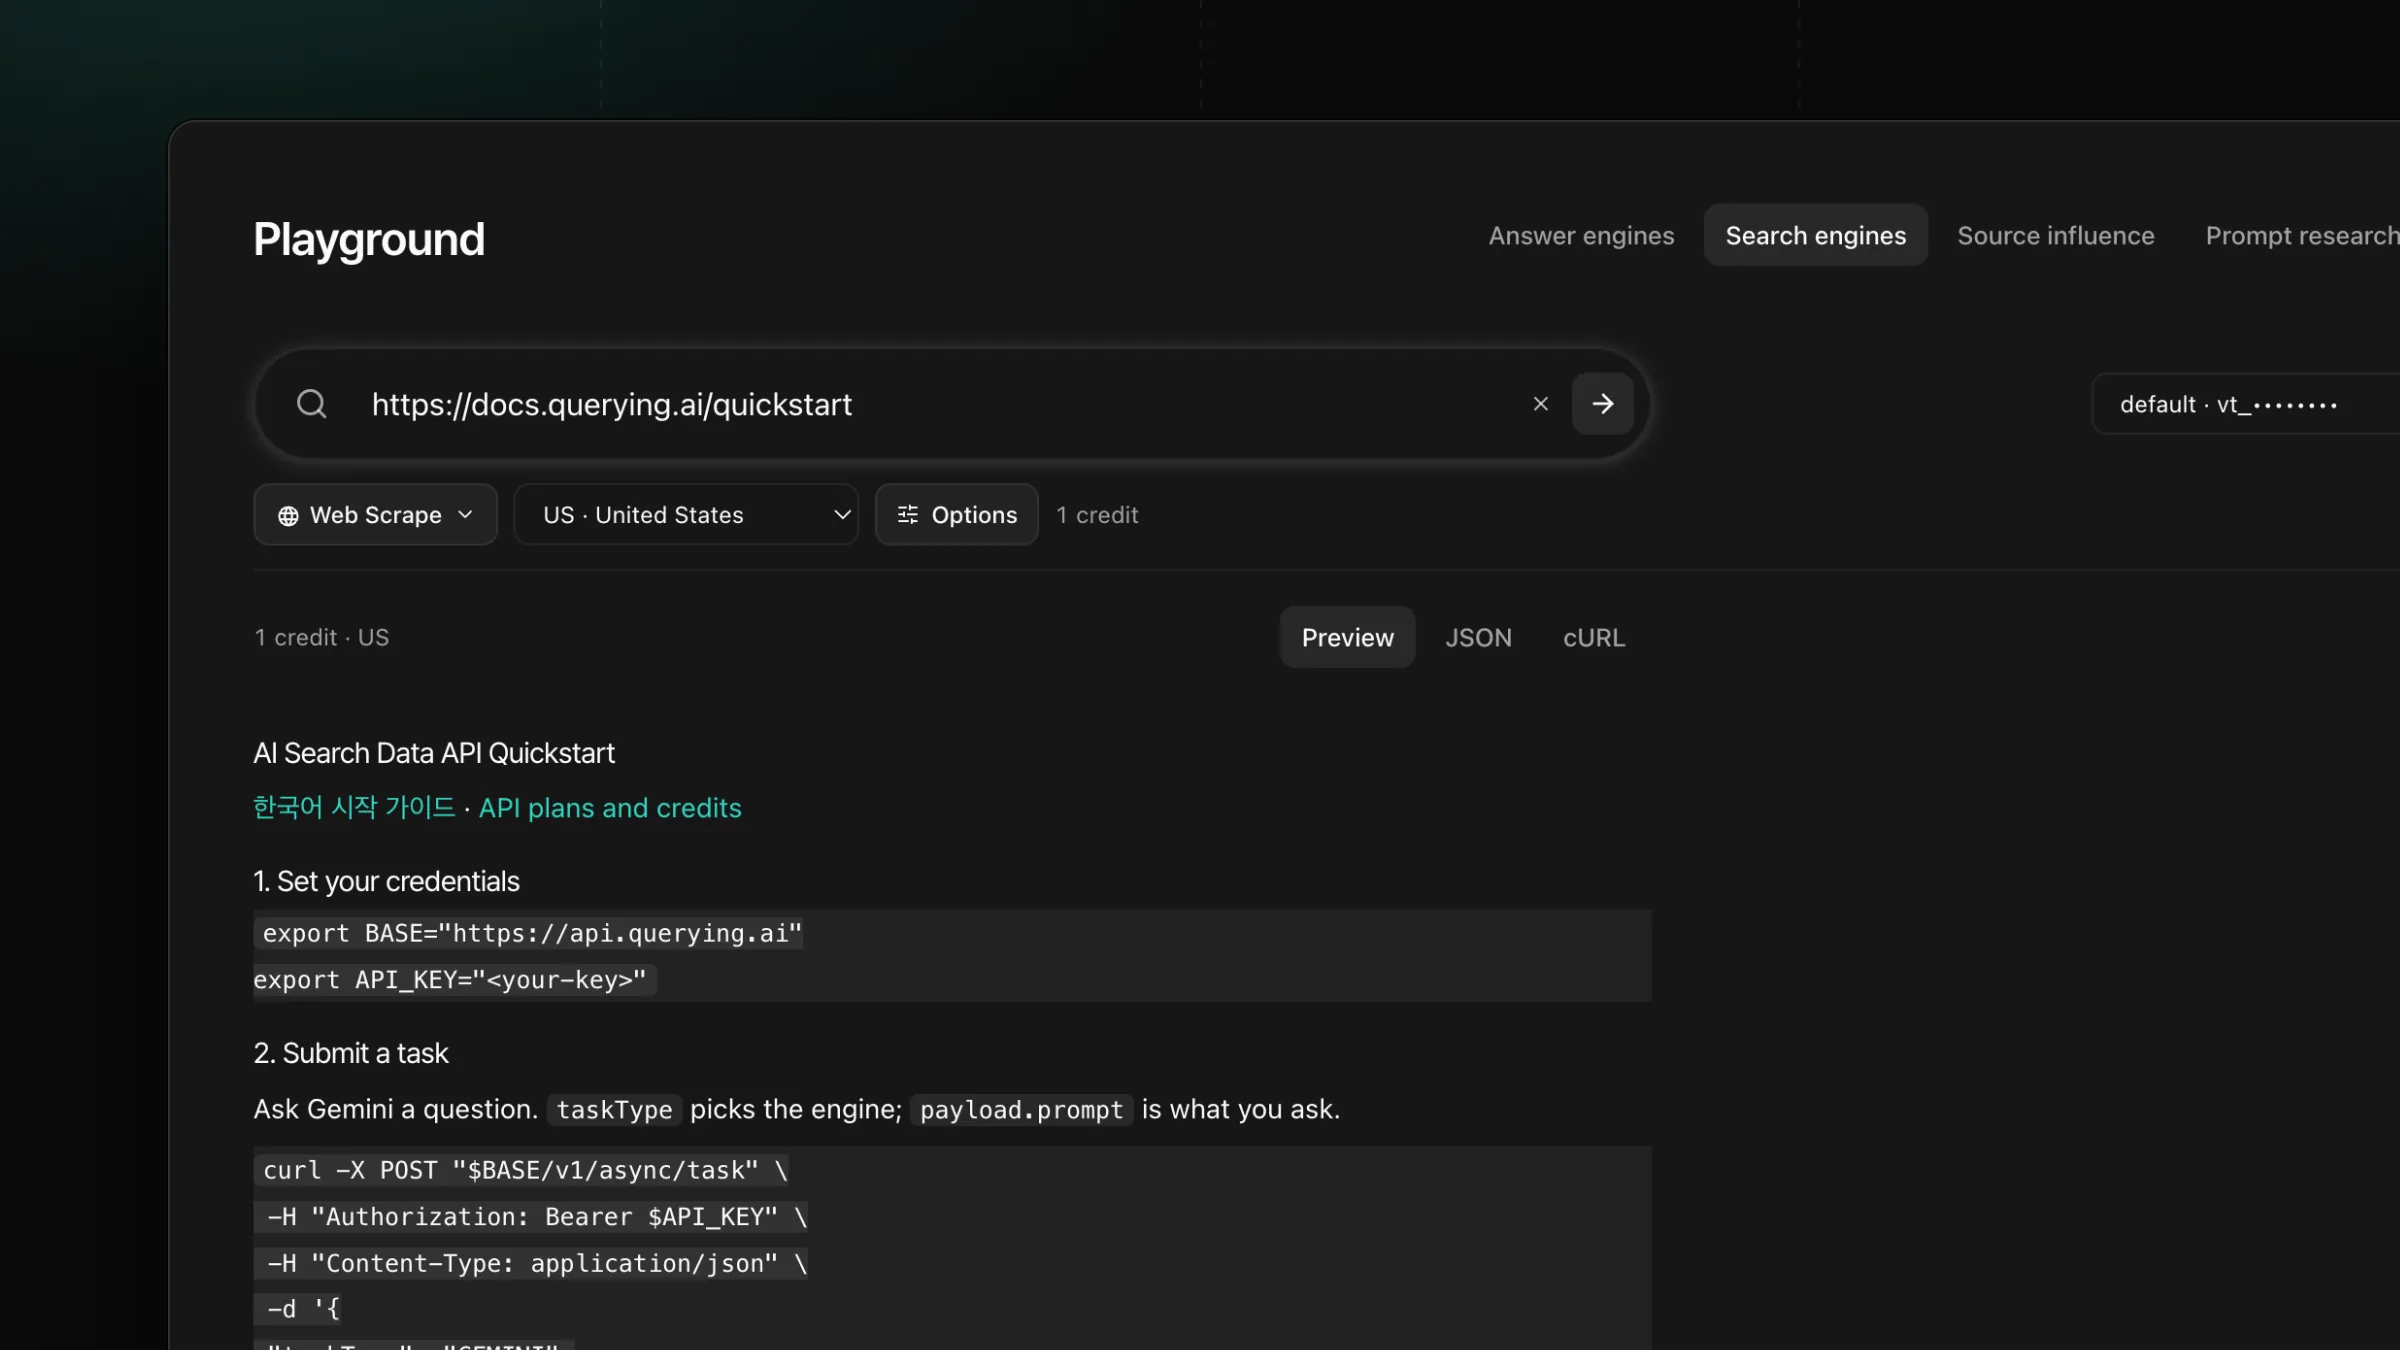
Web Scrape가 URL의 본문을 Markdown으로 가져와요. 완료된 요청당 1크레딧이에요.
markdown: 페이지 본문을 제목, 문단, 목록, 표, 링크, 이미지와 함께 담습니다. 사이트의 머리글, 바닥글, 메뉴는 걸러 냅니다.title, description, author, publishedAt, siteName, language, image: 페이지가 밝힌 정보를 그대로 담습니다.finalUrl, statusCode: 리디렉션 후 최종 주소와 사이트가 돌려준 상태 코드입니다.images: markdown 안의 이미지를 나오는 순서대로 대체 텍스트와 함께 담습니다.공개된 http, https URL을 2,048자까지 보내세요. Web Scrape가 페이지를 열고, 쇼핑몰 상품 페이지처럼 스크립트로 그리는 페이지는 화면을 그린 뒤 읽어, 독자가 보러 온 본문, 표, 이미지를 남깁니다. 결과는 깔끔한 Markdown이라 바로 저장하고 검색하고 분석합니다.
maxChars로 길이를 1,000자에서 200,000자까지 정합니다(기본 100,000자). 긴 페이지는 문단 경계에서 끊고 truncated: true를 표시합니다. country(기본 US)는 페이지를 요청할 언어와 지역을 정합니다. PDF, 404나 410을 돌려주는 페이지, 요청을 거부한 사이트는 PAGE_UNAVAILABLE로 끝나고 메시지에 사이트의 응답이 담깁니다.
GOOGLE_SERP 결과의 link를 넣어 검색어별 상위 페이지를 읽습니다.scrape_page로 AI 어시스턴트에서 바로 페이지를 읽습니다.API 키를 Authorization 헤더에 넣어 요청을 보냅니다.
curl -X POST https://api.querying.ai/v1/async/task \
  -H "Authorization: Bearer $QUERYING_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "taskType": "WEB_SCRAPE",
    "payload": {
      "url": "https://docs.querying.ai/quickstart",
      "country": "US"
    }
}'taskTypestring필수CHATGPT, GOOGLE 같은 값을 넣습니다.payload.urlstring필수payload.maxCharsintegermarkdown 길이 상한, 1,000에서 200,000. 기본값 100,000. 더 긴 페이지는 문단 경계에서 끝나고 truncated가 붙습니다.payload.countrystringUS.webhook.urlstringidempotencyKeystring완료된 태스크는 이런 형태입니다. 길이를 줄여 보여 드립니다.
{
  "success": true,
  "task": {
    "id": "910017b1-4fd5-4bc7-8895-bbe6b1b0d1df",
    "taskType": "WEB_SCRAPE",
    "status": "COMPLETED",
    "createdAt": "2026-10-02T15:48:34.088Z"
  },
  "credits": { "creditsToCharge": 1, "creditsCharged": 1 },
  "response": {
    "url": "https://docs.querying.ai/quickstart",
    "finalUrl": "https://docs.querying.ai/quickstart",
    "statusCode": 200,
    "title": "AI Search Data API Quickstart",
    "description": "Submit a task, receive a result — with webhooks or by polling.",
    "siteName": "querying.ai",
    "language": "en",
    "markdown": "# AI Search Data API Quickstart\n\n[한국어 시작 가이드](https://querying.ai/ko/guides/quickstart) · [API plans and credits](https://querying.ai/en/pricing)\n\n## 1\\. Set your credentials\n\n```shellscript\nexport BASE=\"https://api.querying.ai\"\nexport API_KEY=\"<your-key>\"\n```\n\n…",
    "images": [],
    "truncated": false
  }
}task.statusstringQUEUED, PROCESSING을 거쳐 답변과 함께 COMPLETED로, 또는 error와 함께 FAILED로 끝납니다.credits.creditsChargedintegerresponse.markdownstringresponse.titlestringdescription, author, siteName, language도 함께 옵니다.response.publishedAtstringresponse.finalUrlstringstatusCode입니다.response.imagesarraymarkdown에 든 이미지를 본문 순서대로 담고, 각각 url과 alt가 있습니다.response.truncatedbooleanmarkdown이 maxChars에 닿아 문단 경계에서 끝났으면 true입니다.요청하면 status가 QUEUED인 태스크가 바로 돌아옵니다. status가 COMPLETED나 FAILED가 될 때까지 GET /v1/async/task/{id}로 조회하거나, webhook.url을 넣어 같은 task, credits, response를 서버로 받으세요. 결과는 태스크가 끝난 뒤 24시간 동안 조회됩니다.
curl https://api.querying.ai/v1/async/task/$TASK_ID \
-H "Authorization: Bearer $QUERYING_API_KEY"완료된 페이지마다 1크레딧이 차감됩니다.
CHATGPT, GEMINI, GOOGLE 태스크의 country를 CN이나 HK로 정해 중국 본토와 홍콩 사용자가 보는 답변을 받으세요.
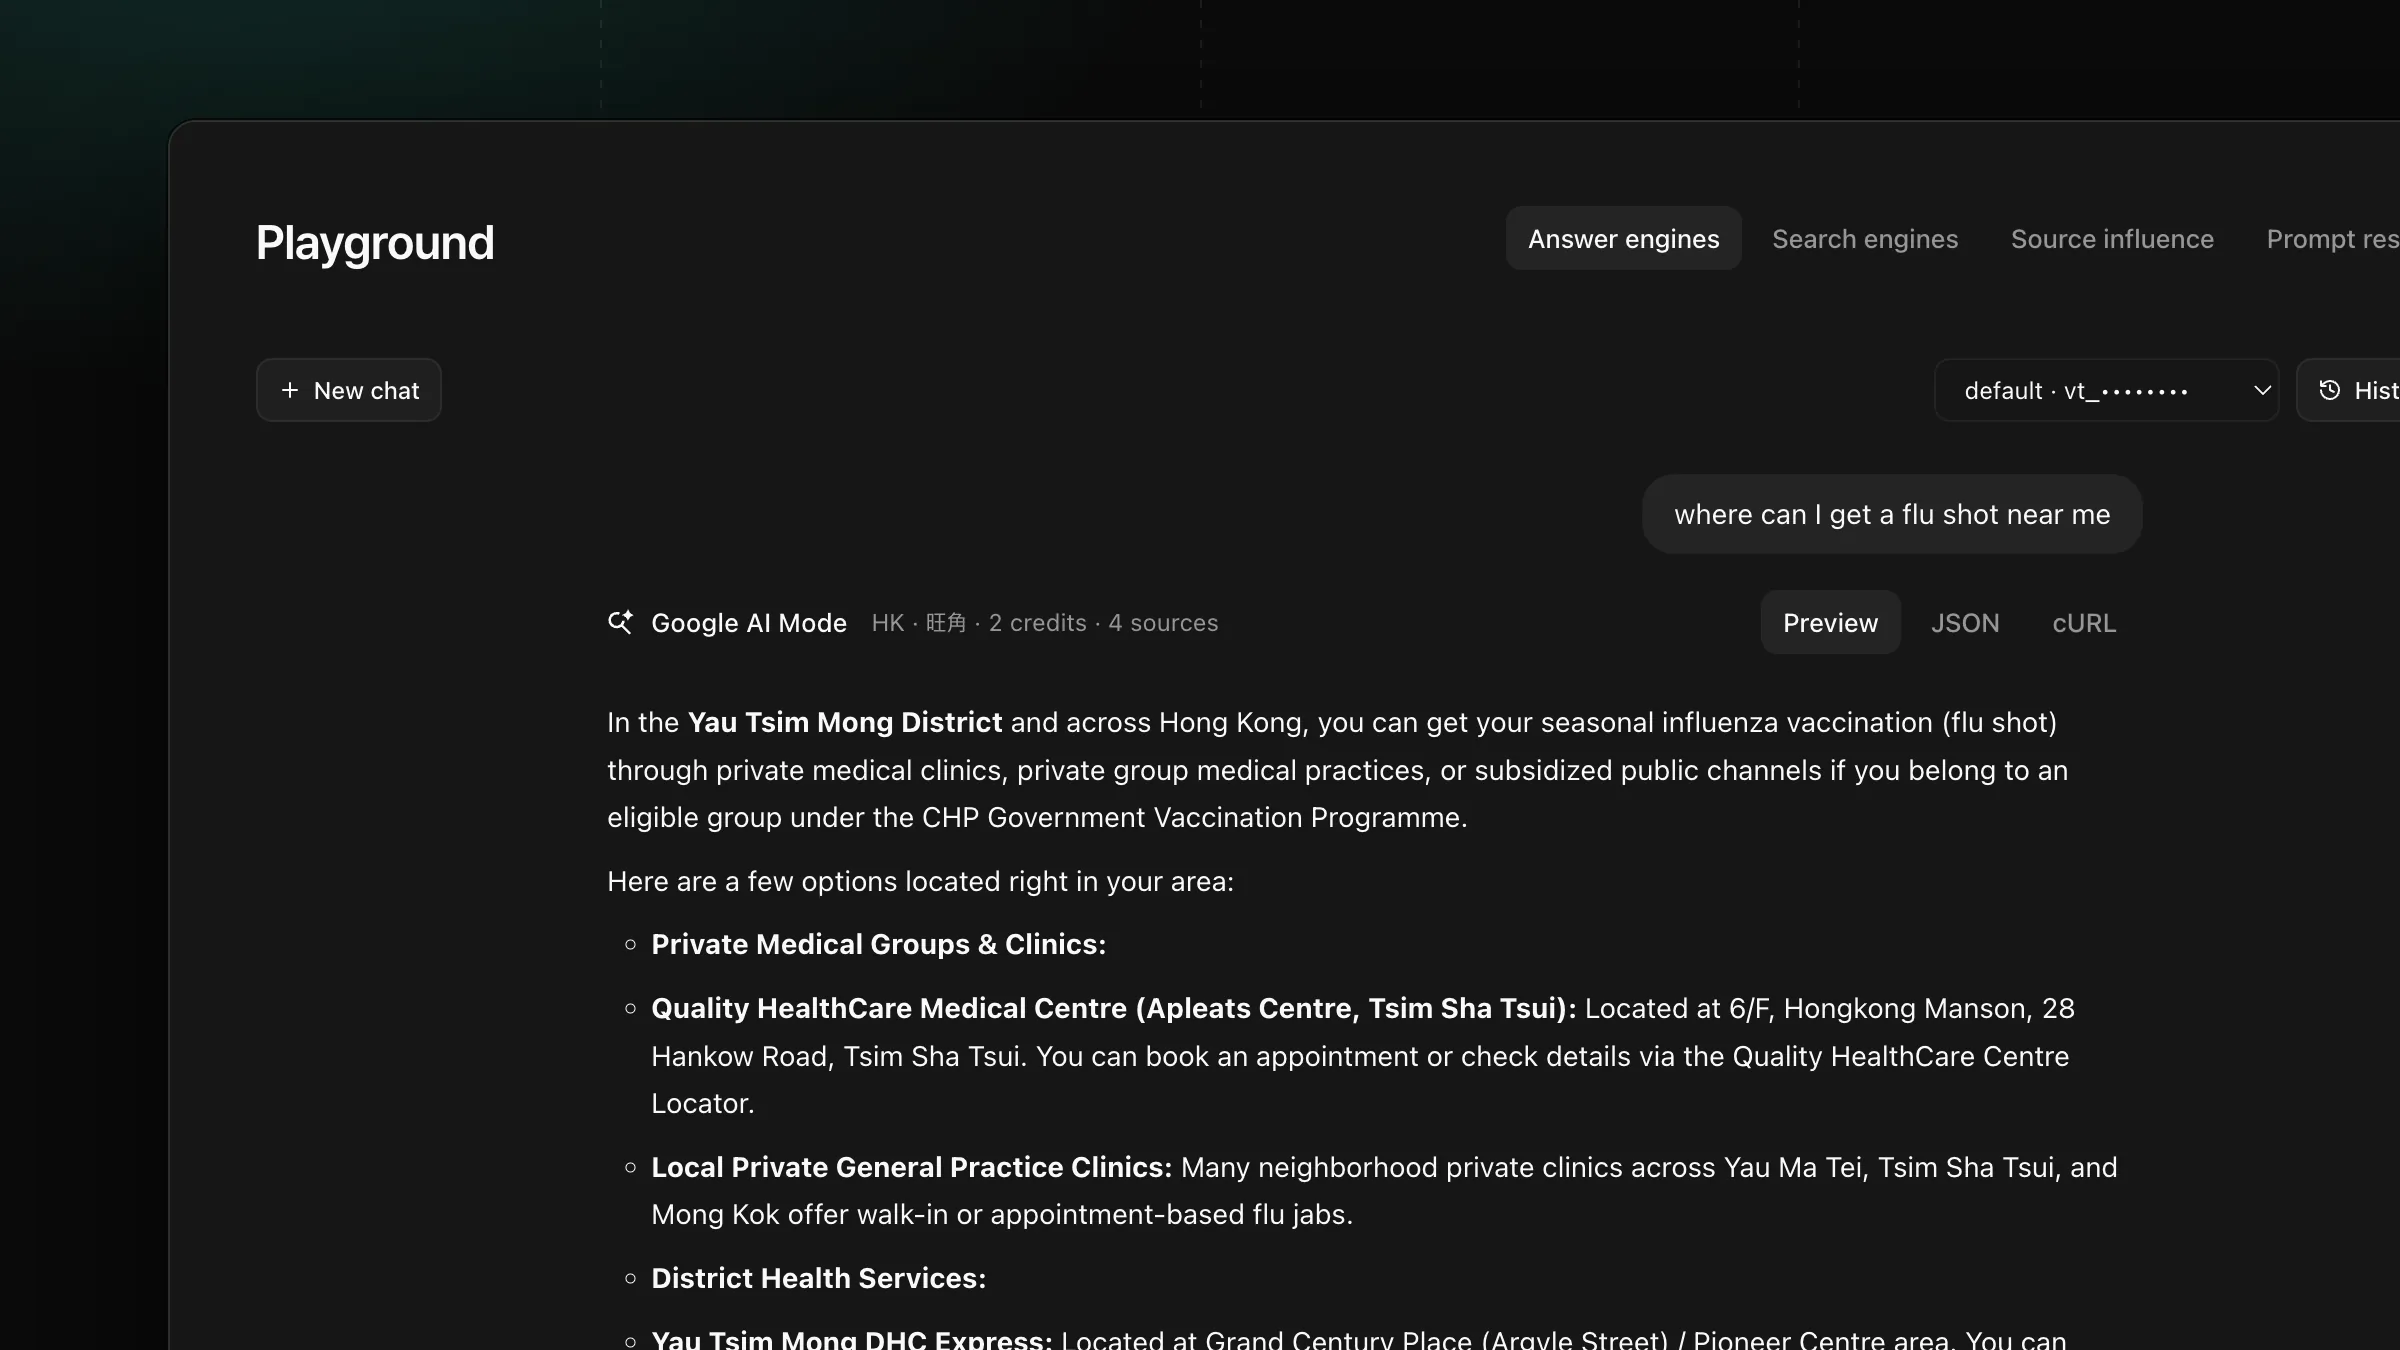
GOOGLE, AIMODE, GOOGLE_SERP 태스크에 payload.location을 넣어 그 장소의 사용자가 보는 AI Overview, AI Mode 답변, 검색 결과를 받으세요.
제품 업데이트를 이메일로 보내드립니다.